
开始之前
本课跟的是 2026 年 11 月 4 日的 n8n 文档,默认你已经学过第一个工作流那一课:会搭工作流、会发布、会看执行记录。错误工作流只对自动运行起反应,所以被它监控的工作流需要一个不用你动手就会触发的触发器,比如定时或 Webhook,并且必须已经发布。
有一个设置决定了处理器能报告多少内容。文档说,execution.id 和 execution.url 只有在执行记录保存到数据库时才存在,所以凡是要发告警的工作流,都把 Save failed production executions 保持开启。
搭建处理器并接到工作流上
处理器就是一个普通的工作流,第一个节点是 Error Trigger。下面这条消息是为本课写的示例,用的是文档里数据结构的字段名。把它放进接在触发器后面的 Slack 或 Send Email 节点:
Workflow failed: {{ $json.workflow.name }}
Last node: {{ $json.execution.lastNodeExecuted }}
Error: {{ $json.execution.error.message }}
Execution: {{ $json.execution.url }}- 新建一个工作流,把 Error Trigger 节点加为第一个节点。
- 给它起个名字,比如
Error Handler,然后选择 Save。Error Trigger 页面说,用了这个节点的工作流不需要发布。 - 在触发器后面加一个通知节点,比如 Slack 或 Send Email,把上面的示例粘贴成消息内容。
- 打开要监控的工作流。在工作流菜单里选择 Settings,在 Error workflow (to notify when this one errors) 下选中你的处理器,再选择 Save。
- 给被监控的工作流造一个随时可触发的失败:一个 Schedule Trigger 后面接一个 Stop And Error 节点,并发布。本课最后一节会讲这个节点。
- 定时触发之后,打开处理器的 Executions 标签,看它收到了什么。在被监控的工作流上点 Execute workflow 说明不了任何事,因为 Error Trigger 只在自动执行出错时才运行。
Error Trigger 会收到什么
默认情况下,触发器收到的是一个数组,里面有一个 execution 对象和一个 workflow 对象,见下面错误处理指南里给出的数据。
主工作流自己的触发器节点失败时,结构会变。这时工作流根本没有执行,所以 execution 里的内容变少,细节放进了 trigger 对象:一个 error,带有 WorkflowActivationError 这样的名称、消息、原因、时间戳和节点,另外 mode 是 trigger。读取 execution.error.message 的处理器,需要为这种情况再加一条分支。
[
	{
		"execution": {
			"id": "231",
			"url": "https://n8n.example.com/execution/231",
			"retryOf": "34",
			"error": {
				"message": "Example Error Message",
				"stack": "Stacktrace"
			},
			"lastNodeExecuted": "Node With Error",
			"mode": "manual"
		},
		"workflow": {
			"id": "1",
			"name": "Example Workflow"
		}
	}
]| 字段 | 什么时候没有 | 原因 |
|---|---|---|
execution.id、execution.url | 错误出在主工作流的触发器节点 | 工作流根本没运行,而且这两个字段都需要已保存的执行记录 |
execution.retryOf | 这次执行不是重试 | 只有这次运行是在重试一次失败的执行时才出现 |
trigger | 错误不在触发器节点 | 触发器失败时,细节放在这里,mode 为 trigger |
一次运行内部的失败:重试与 On Error
错误工作流是在一次执行已经失败之后才行动,节点设置则出手更早。打开节点的 Settings 标签,能看到 Retry On Fail 和 On Error,文档对它们各用一行话描述。
Retry On Fail 那一行说节点会一直重跑到成功。执行引擎的源码划的线更紧:maxTries 默认是 3,限制在 2 到 5 之间,waitBetweenTries 默认是 1000 毫秒,限制在 0 到 5000 之间。根据编辑器的英文字符串,这两项在界面上叫 Max. Tries 和 Wait Between Tries (ms)。重试能解决自己会消失的超时或限流,换成错误的 API 密钥,每次都会以同样的方式失败。
On Error 有三个取值。Continue 在源码里藏着一个陷阱:节点自己抛出错误时,n8n 把这个节点的输入数据交给下一个节点,于是后面的流程接着跑在失败节点根本没处理过的数据上。而且这次运行最后没有失败,错误工作流也就不会出声。
| Stop Workflow | Continue | Continue (using error output) 我们的选择 | |
|---|---|---|---|
| 让执行失败,错误工作流因此运行 | 是 | 否 | 否 |
| 失败节点之后的节点继续运行 | 否 | 是 | 是 |
| 失败的数据项从额外的错误输出口送出 | 否 | 否 | 是 |
我们的选择:Continue (using error output)。 失败的数据项有了自己的分支,后面的节点可以告警、记录或重试它们,其余部分照常跑完。
来源:n8n 文档:节点 (2026年11月4日 查阅);n8n 文档:优雅地处理错误 (2026年11月4日 查阅);n8n 仓库:编辑器字符串 (2026年11月4日 查阅);n8n 仓库:执行引擎 (2026年11月4日 查阅)
会改变失败后留下什么的工作流设置
工作流设置里有四项,决定失败之后你能看到什么。自托管时,它们在整个实例层面都有对应的环境变量,比如 EXECUTIONS_DATA_SAVE_ON_ERROR 和 EXECUTIONS_TIMEOUT。
超时是最容易被忘掉的一项。执行变量页面列出的 EXECUTIONS_TIMEOUT 默认值是 -1,表示关闭超时,所以卡住的执行会一直跑下去,没有处理器会知道。必须跑完的工作流,要打开 Timeout Workflow。
| 设置 | 文档怎么说 |
|---|---|
| Error workflow | 当前工作流失败时要触发的工作流 |
| Save failed production executions | n8n 是否保存已发布工作流的失败执行 |
| Save execution progress | 设为 Save 后,出错时工作流会从停下的地方继续,这可能增加延迟 |
| Timeout Workflow | 过了设定的时间就取消这次执行,在 n8n Cloud 上,每个套餐有自己的最长时限 |
用 Stop And Error 主动失败
有些出问题的运行根本不会报错。接口返回 200 却是个空列表,或者你依赖的某个字段不存在。Stop And Error 把这种情况变成一次失败的执行,错误工作流就会触发。
它有两种操作。Error Message 多出一个字段,填要抛出的消息。Error Object 接收一个 JSON 对象,里面是你想抛出的错误属性。把这个节点放在 If 节点的 false 分支上,由 If 去检查你需要的那个条件。
谁会收到通知
在付费套餐上,被设为错误工作流的那个工作流的运行不计入执行额度,所以处理器再啰嗦也不花额度。
n8n 2.5 在 2026 年 1 月 20 日发布,从这个版本起,如果实例里还没有错误工作流,工作流第一次在生产环境失败时,n8n 会给工作流的所有者发一封邮件。每个实例只发一次,所以它只是个提醒,算不上监控。想把事件送到自己的日志系统,内置的办法是日志流,它在 Cloud 和自托管上都是 Enterprise 功能。
n8n 团队怎么说错误工作流和重试
2026 年 9 月 9 日,n8n 团队在 X 上说,错误工作流的运行现在在所有 n8n 套餐上都免费。Cloud 上已经生效,自托管从 2.38.0 版起生效。帖子的理由是,安全网不该和它保护的自动化抢额度。所以每个生产工作流,都应该指向你在这一课搭好的处理器。
更早一些,2026 年 6 月 18 日,团队在 X 上的一条回复讲了重试这件事。同样的要求再提一遍,得到的还是同样的答案。把确切的错误发回去,第二次尝试才有的放矢。
普通的 Retry On Fail 只是把同样的请求再发一次,适合服务一时繁忙或宕机的情况。对于要检查输出的步骤,比如 AI 节点,用 Continue (using error output) 接住失败,再把错误信息放进下一次尝试里。
错误工作流的运行,现在在所有 n8n 套餐上都免费。你的安全网,不该和它保护的自动化抢额度。
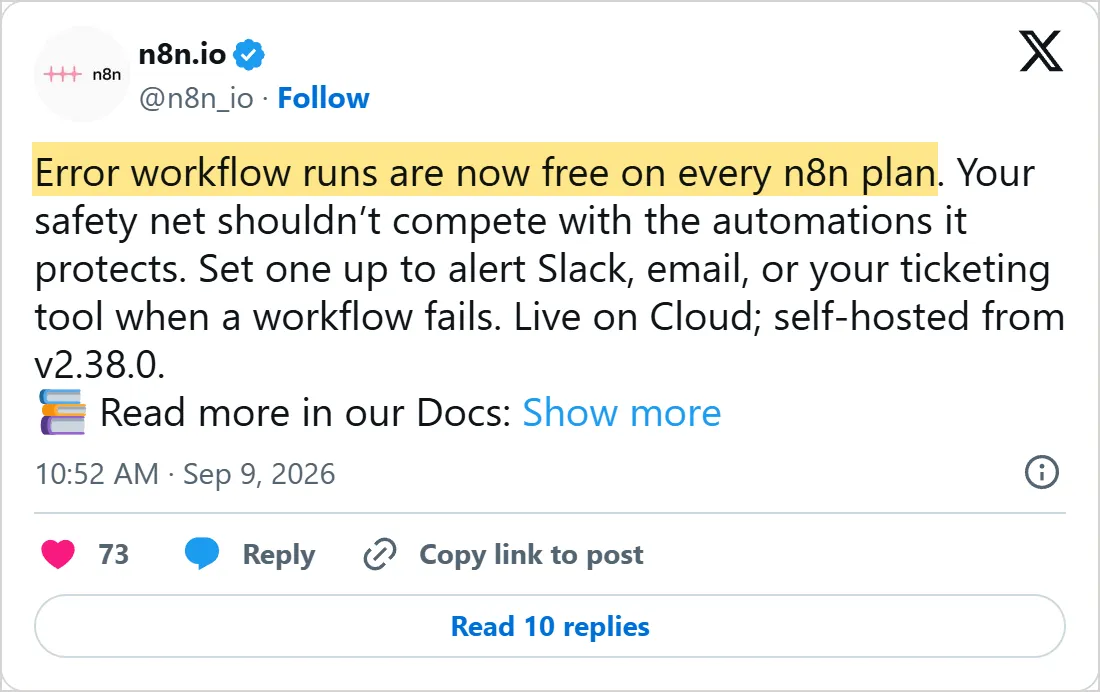
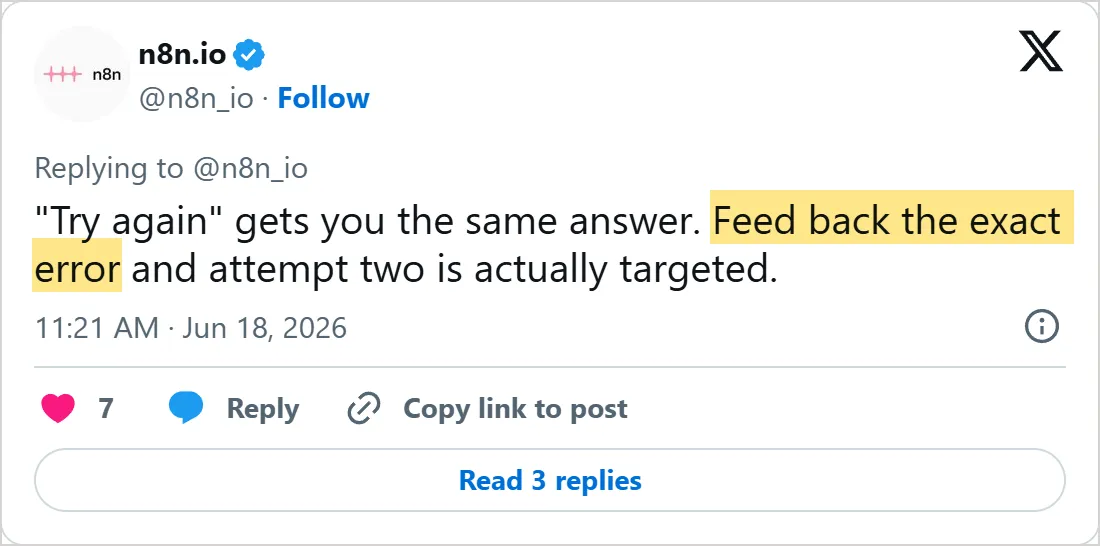

X 官方嵌入卡片的截图,拍摄于 2026 年 11 月 5 日,时间为 UTC。X 在第一条帖子处用“Show more”截断了后面的内容。点击截图可到 X 上打开原帖。
常见错误
- 用 Execute workflow 来测试。处理器不理会手动运行,所以要发布被监控的工作流,让它的触发器自己触发。
- 忘了默认行为。包含 Error Trigger 节点的工作流,默认把自己当作错误工作流,所以处理器自己的 Error workflow 设置也要检查。
- 以为
execution.url一定存在。触发器失败之后,数据里没有execution.id和execution.url,细节在trigger里。 - 用了 Continue 就再也不看。执行显示成功,处理器保持沉默,下一个节点还可能跑在失败节点的输入数据上。更好的做法是选 Continue (using error output),并处理那条分支。
- 什么都重试。重试对超时和限流有用,而错误的凭据或写错的表达式,每次尝试都会失败,默认就是三次。
- 没读 n8n 3.0 的改动就给 If 或 Switch 节点打开 Always Output Data。在目前处于抢先体验阶段的 3.0 里,这个设置打开后,这类节点只在所有输出都为空时才加一个空数据项。2.x 里每个空输出都会得到一个,所以不该跑的分支也可能跑起来。
自己试一试
- 按本课搭好处理器,把它接到一个以 Stop And Error 结尾的定时工作流上,在处理器的执行记录里看收到的数据。
- 给一个请求会返回错误的 HTTP Request 节点打开 Retry On Fail,把 Max. Tries 设成 2,把 Wait Between Tries (ms) 设成 2000,再和关掉重试时的运行时间比较。
- 把一个节点改成 Continue (using error output),并把它的错误输出口接到 Slack 或 Send Email 节点。
- 打开一次失败的生产执行,选择 Debug in editor。调试页面说,n8n 会把数据复制到你的工作流里,并固定在第一个节点上。
接下来学什么
第 2 课把一个大工作流拆成子工作流,可以建一次,到处调用,告警步骤也能做成这样。想从现成的处理器开始,导入 n8n 工作流那篇讲了怎样把一个导入自己的实例,Mindket 的 n8n 工作流里也有现成的可选。
自测一下
错误工作流必须以哪个节点开头?
查看答案
B. Error Trigger 文档说错误工作流必须以 Error Trigger 节点开头。
你在一个会失败的工作流上点了 Execute workflow,它的错误工作流会收到什么?
查看答案
C. 什么都收不到,因为 Error Trigger 只在自动执行时运行 Error Trigger 页面说,错误工作流不能用手动运行来测试。
一个节点失败了,你想让失败的数据项走单独的分支,其余运行继续。该选哪个 On Error 设置?
查看答案
A. Continue (using error output) 这个设置会为失败的数据项增加一个错误输出口,后面的节点继续运行。
Retry On Fail 适合处理哪种失败?
查看答案
D. 自己会消失的超时 重试只是重跑同一个节点,所以只有原因在两次尝试之间消失时才有用。
常见问题
能用手动运行来测试 n8n 的错误工作流吗?
不能。想随时看到处理器运行,就在被监控的工作流里放一个 Stop And Error 节点,发布它,再用一个每分钟触发一次的 Schedule Trigger 启动一次。试完记得取消发布。
一个错误工作流能监控多个工作流吗?
能。在每个工作流的设置里选同一个处理器即可。数据里带有 workflow.id 和 workflow.name,所以一个消息模板就能写出是哪个工作流失败了。
错误工作流本身需要发布吗?
不需要。Error Trigger 页面说,用了 Error Trigger 节点的工作流不需要发布。被它监控的工作流则需要发布,因为只有自动运行才会触发处理器。
错误工作流的运行计入执行额度吗?
不计入。在付费套餐上,只有生产执行才计入额度,文档把被设为错误工作流的那个工作流的运行,列在不计入的情况里。
Retry On Fail 和错误工作流有什么区别?
Retry On Fail 在同一次执行里重跑一个节点。错误工作流则是在整次执行失败之后,另外启动一个工作流。会自己恢复的失败用重试,需要人来处理的失败用处理器。
失败执行的数据能找回到编辑器里吗?
能。在 Executions 标签里选一次失败的执行,选择 Debug in editor,n8n 会把数据复制到你的工作流里,并固定在第一个节点上。文档里写明,Cloud 全部套餐可用,自托管则是已注册的 Community、Business 和 Enterprise。
资料来源
- n8n Docs: Handle errors gracefully https://docs.n8n.io/build/flow-logic/handle-errors-gracefully
- n8n Docs: Error Trigger node https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.errortrigger
- n8n Docs: Stop And Error node https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.stopanderror
- n8n Docs: Work with nodes https://docs.n8n.io/build/understand-workflows/workflow-components/work-with-nodes
- n8n Docs: Configure workflow settings https://docs.n8n.io/build/manage-workflows/configure-workflow-settings
- n8n Docs: Understand executions https://docs.n8n.io/build/understand-workflows/understand-executions
- n8n Docs: Debug executions https://docs.n8n.io/build/understand-workflows/understand-executions/debug-executions
- n8n Docs: Stream logs to external systems https://docs.n8n.io/administer/observe-and-log/stream-logs-to-external-systems
- n8n Docs: Executions environment variables https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/use-environment-variables/executions
- n8n Docs: v3.0 breaking changes https://docs.n8n.io/changelog/v30-breaking-changes
- n8n Docs: Release notes https://docs.n8n.io/changelog/release-notes
- n8n repository: execution engine (workflow-execute.ts) https://github.com/n8n-io/n8n/blob/master/packages/core/src/execution-engine/workflow-execute.ts
- n8n repository: editor strings (en.json) https://github.com/n8n-io/n8n/blob/master/packages/frontend/@n8n/i18n/src/locales/en.json
- n8n.io on X: error workflow runs are now free on every n8n plan, 9 September 2026 https://x.com/n8n_io/status/2097639369079181575
- n8n.io on X: feed back the exact error, 18 June 2026 https://x.com/n8n_io/status/2067568466161221784
- n8n on YouTube: n8n Advanced Course (5/8) - Error workflows https://www.youtube.com/watch?v=77Ewdaby47M