
不到 80 行 Python 写成的 harness
把同一个模型分别放进 Claude Code、Codex 和你自己写的脚本,你会得到三个不同的智能体。模型权重没变,变的是它外围的代码。OpenAI 的 Codex 团队和 Anthropic 都把这部分叫作 harness,也就是模型外围的代码:调用模型的循环、它能用的工具、它每一轮看到的内容,以及每个动作前后的检查。
下面这段示意代码,差不多是把这些部分都装齐的最小 harness。代码是本课自己写的,外面包着两个工具定义,原样取自 Anthropic 的客服智能体示例,本课没有运行过它。注释标出了每一行属于哪个部分。循环本身在 Claude API 智能体那一课里一步步搭过,这里只做标注。
import anthropic

from orders import cancel_order, get_order_details  # the cookbook's stand-in functions

client = anthropic.Anthropic()
MODEL = "claude-opus-5-5"
MAX_TURNS = 10                     # check: end a run that never stops
NEEDS_APPROVAL = {"cancel_order"}  # permission: tools that change something

# tools: two of the cookbook's three definitions, as written there
TOOLS = [
    {
        "name": "get_order_details",
        "description": "Retrieves the details of a specific order based on the order ID. Returns the order ID, product name, quantity, price, and order status.",
        "input_schema": {
            "type": "object",
            "properties": {
                "order_id": {
                    "type": "string",
                    "description": "The unique identifier for the order.",
                }
            },
            "required": ["order_id"],
        },
    },
    {
        "name": "cancel_order",
        "description": "Cancels an order based on the provided order ID. Returns a confirmation message if the cancellation is successful.",
        "input_schema": {
            "type": "object",
            "properties": {
                "order_id": {
                    "type": "string",
                    "description": "The unique identifier for the order to be cancelled.",
                }
            },
            "required": ["order_id"],
        },
    },
]
FUNCTIONS = {"get_order_details": get_order_details, "cancel_order": cancel_order}


def allowed(name, args):
    if name not in NEEDS_APPROVAL:
        return True
    return input(f"Allow {name} {args}? (y/n) ").strip().lower() == "y"


def run_agent(task):
    messages = [{"role": "user", "content": task}]  # context: all the model sees next turn
    for _ in range(MAX_TURNS):  # the loop
        response = client.messages.create(
            model=MODEL, max_tokens=2048, tools=TOOLS, messages=messages
        )
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return "".join(b.text for b in response.content if b.type == "text")
        results = []
        for block in response.content:
            if block.type != "tool_use":
                continue
            if allowed(block.name, block.input):
                fn = FUNCTIONS[block.name]
                output, failed = fn(**block.input), False
            else:
                output, failed = "The user declined this action.", True
            results.append({
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": str(output),
                "is_error": failed,
            })
        messages.append({"role": "user", "content": results})
    return "Stopped: the turn limit was reached."


print(run_agent("Please cancel order O1 for me."))- 工具。两个定义告诉模型它可以请求做什么。模型自己什么都不执行:是你的代码在
FUNCTIONS里按名字找到函数,再去调用它。 - 上下文。
messages装着模型下一次调用时看到的全部内容。每一轮都会追加模型的回复和工具结果,所以每次请求都比上一次大。 - 权限。
allowed()会拦住cancel_order,直到有人输入 y。被拒绝的调用会作为设置了is_error的工具结果返回,模型就能告诉用户,而不是盲目重试。 - 检查。模型一直要工具时,
MAX_TURNS会结束这次运行。Anthropic 的《Building effective agents》提到,常见做法是加上停止条件,比如最大迭代次数,以便保持控制,而 API 把这个计数留给了你。 - 循环。调用模型,执行它要的工具,追加结果,再调用一次,直到某次回复里不再有工具调用。
你开口之前,Codex 已经替模型准备好了什么
OpenAI 的 Michael Bolin 在 2026 年 1 月 23 日发表的《Unrolling the Codex agent loop》里拆解了 Codex CLI,他把这个智能体称为让模型发挥作用的“harness”。你的消息到达模型之前,Codex 已经拼好了请求里的另外六个部分,表格按顺序列出了它们。
这套拼装里有一条权限事实,加工具之前最好先知道。权限消息里描述的沙盒,只作用于 Codex 自带的 shell 工具。来自 MCP 服务器的工具不受 Codex 沙盒约束,要自己负责自己的安全护栏。
顺序关系到速度和成本。每次请求都会重发整段对话,旧的提示词恰好是新提示词的前缀,提示词缓存正是靠这一点复用之前的计算。如果在对话中途改了工具、模型、沙盒、审批模式或工作目录,缓存就会失效。所以设置有变化时,Codex 会追加一条新消息来记录,而不去改前面的消息。它早期的 MCP 支持曾因为工具列出的顺序不固定而导致缓存失效,后来才修好。提示词缓存那一课讲的是 Claude 上同样的前缀规则。
上下文是另一份预算。对话长度超过 auto_compact_limit 时,Codex 会调用 Responses API 的 /responses/compact 端点,然后用它返回的更短的条目列表继续对话。
| 部分 | 角色 | 里面装的是 |
|---|---|---|
instructions | system 或 developer | 设置了的话,用 ~/.codex/config.toml 里的 model_instructions_file,否则用随模型打包的基础指令 |
tools | 不是一条消息 | Codex 自己的工具,比如 shell 和 update_plan,Responses API 的 web_search,以及你的 MCP 服务器提供的工具 |
| 权限说明 | developer | shell 工具的沙盒、运行命令前什么时候要先问,以及 Codex 可以写入哪些文件夹 |
| 开发者指令 | developer | config.toml 里可选的 developer_instructions |
| 用户指令 | user | $CODEX_HOME 里,以及从项目根目录到工作目录之间每个文件夹里的 AGENTS.override.md 和 AGENTS.md,默认最多 32 KiB,另加技能的元数据 |
| 环境上下文 | user | 工作目录和所用的 shell |
| 你的消息 | user | 你输入的任务 |
Harness 工程:OpenAI 那个没有一行手写代码的产品
OpenAI 的 Ryan Lopopolo 在 2026 年 2 月 11 日发表的《Harness engineering》里,讲了团队花五个月做一个内部产品、没有任何人手写一行代码的经过。第一版脚手架由 Codex CLI 在 GPT-5 上生成,时间是 2025 年 8 月下旬,连最初的 AGENTS.md 也是 Codex 写的。下面的数字是团队自己公布的。
起初进展很慢,文章把原因归于环境描述不足,而不是模型不行。所以每次出问题,工程师们都会问:“缺的是什么能力,怎样让智能体既能看懂它,又必须遵守它?”早期的一个答案和指令文件有关。一个庞大的 AGENTS.md 会挤掉任务本身,内容很快过时,也没法用程序检查,于是它被改成一份大约 100 行的目录,指向 docs/ 文件夹。lint 和 CI 任务会检查这个文件夹是否过时、交叉链接是否完整,还有一个专门“打理文档”的智能体为过时的页面提交修复。文章给出的目录结构如下:
AGENTS.md
ARCHITECTURE.md
docs/
├── design-docs/
│   ├── index.md
│   ├── core-beliefs.md
│   └── ...
├── exec-plans/
│   ├── active/
│   ├── completed/
│   └── tech-debt-tracker.md
├── generated/
│   └── db-schema.md
├── product-specs/
│   ├── index.md
│   ├── new-user-onboarding.md
│   └── ...
├── references/
│   ├── design-system-reference-llms.txt
│   ├── nixpacks-llms.txt
│   ├── uv-llms.txt
│   └── ...
├── DESIGN.md
├── FRONTEND.md
├── PLANS.md
├── PRODUCT_SENSE.md
├── QUALITY_SCORE.md
├── RELIABILITY.md
└── SECURITY.md- 规则变成代码。自定义 lint 和结构测试把每个业务领域限定在固定的分层里(Types、Config、Repo、Service、Runtime、UI),并强制结构化日志、命名规范和文件大小上限。lint 的报错信息专门写给智能体看,告诉它怎样修好自己弄坏的地方。
- 智能体能“看见”应用。每个 git worktree 都能启动一份自己的应用,接入 Chrome DevTools Protocol,日志和指标可以让智能体用 LogQL 和 PromQL 查询。
- 清理按计划进行。团队过去每个星期五都在收拾智能体留下的问题。现在“黄金原则”写进了仓库,后台的 Codex 任务会对照它们提交小的重构拉取请求。
文章说明,这种做法依赖那个仓库特定的结构和工具,没有类似的投入,不应假定能照搬到别处。
Claude Agent SDK 和 OpenAI Agents SDK 替你搭好了什么
上面这些都不需要框架。Anthropic 的《Building effective agents》(2024 年 12 月)建议先直接用模型的 API,很多模式几行代码就能实现。如果要用框架,就要弄懂它底下的代码,因为对框架内部的错误假设,是客户出错的常见原因。这篇文章顶部现在有一条说明:文中描述的不少工具,自 2024 年 12 月以来已经变了。
两大 SDK 都是只需配置而不必自己写的 harness。Anthropic 在 2025 年 9 月把 Claude Code SDK 改名为 Claude Agent SDK,理由是驱动 Claude Code 的这套智能体 harness 也能驱动很多别的智能体。它的 Python 包自带 Claude Code CLI,默认附带完整的 Claude Code 工具集。
OpenAI 的 Agents SDK 不绑定模型提供方,它把智能体、沙盒智能体、工具、护栏、人工介入、会话和追踪列为核心部分。下面的矩阵按 harness 的部件,根据两份 README 把它们排在一起。Claude Agent SDK 那一课和 OpenAI Agents SDK 那一课分别讲了怎样搭起来。
比较稳妥的分法是:一个窄任务、一两个工具,用你自己的循环;需要文件工具、审批和钩子了,就换 SDK。
| 你自己的循环 | Claude Agent SDK | OpenAI Agents SDK | |
|---|---|---|---|
| 运行循环 | 否 | 是 | 是 |
| 内置文件和 shell 工具 | 否 | 是 | 用 SandboxAgent |
| 工具运行前的审批 | 要自己写 | 是 | 是 |
| 每一步前后的检查 | 要自己写 | Hooks | Guardrails |
| 能驱动的模型 | 你调用的任何 API | Claude | OpenAI 模型和另外 100 多种 |
来源:anthropics/claude-agent-sdk-python README (2026年11月6日 查阅);openai/openai-agents-python README (2026年11月6日 查阅)
harness 的每个部件,都是对模型的一次押注
Anthropic Labs 团队的 Prithvi Rajasekaran 在 2026 年 3 月的《Harness design for long-running application development》里把这条规律说得很直白。harness 里的每个部件,都编码了一个“模型自己做不到什么”的假设,而模型变强以后,这些假设会过时。
他自己的 harness 就是例子。Claude Sonnet 4.5 在上下文快满时会提前收尾,文章称之为“上下文焦虑”,所以 harness 会清空上下文,再通过文件交接状态。到了 Opus 4.5,这个毛病基本消失了,重置也就拿掉了。Opus 4.6 出来后,把工作切成小块的冲刺结构也拿掉了。
值得照搬的是他的方法。一次性大刀阔斧地砍掉 harness,质量会下降,也说不清哪些部件在真正承重。一次只拆一个部件,再检查结果,这个办法行得通。长时间运行的智能体那一课会搭起这套 harness 所来自的多会话版本。
写下 OpenAI 那篇 harness 文章的 Ryan Lopopolo,谈上下文和“管道活”
Ryan Lopopolo 写了那篇 Harness 工程文章,按他在 X 上的简介,他现在是 Google Cloud 的首席工程师。2026 年 3 月 7 日,他在 X 上回答一个问题时,把这项工作分成两件事。一是把所有非功能性需求放到智能体能拉进上下文的地方,二是尽量减少完成高质量工作对上下文的占用。用本课的话说,docs 文件夹和 lint 负责第一件,简短的 AGENTS.md 和安静的工具输出负责第二件。
4 月 15 日,他发帖说,新的 Agents SDK 正是他 2025 年 9 月就希望拥有的东西,还特别提到它“自带沙盒”的设计。他的建议是让 SDK 去做管道活,把精力花在用户身上。这和上面的矩阵对得上:循环、工具和审批拿现成的,把时间留给只有你的产品才懂的上下文和检查。
他讲这个实验的主题演讲,后面还有一段问答,收录在 AI Engineer 频道上。他的 Harness 工程仓库收集了他的帖子和笔记,供智能体阅读。
Harness 工程分两部分:把所有非功能性需求放进一个能被拉进上下文的地方,再尽量降低对上下文的需求。
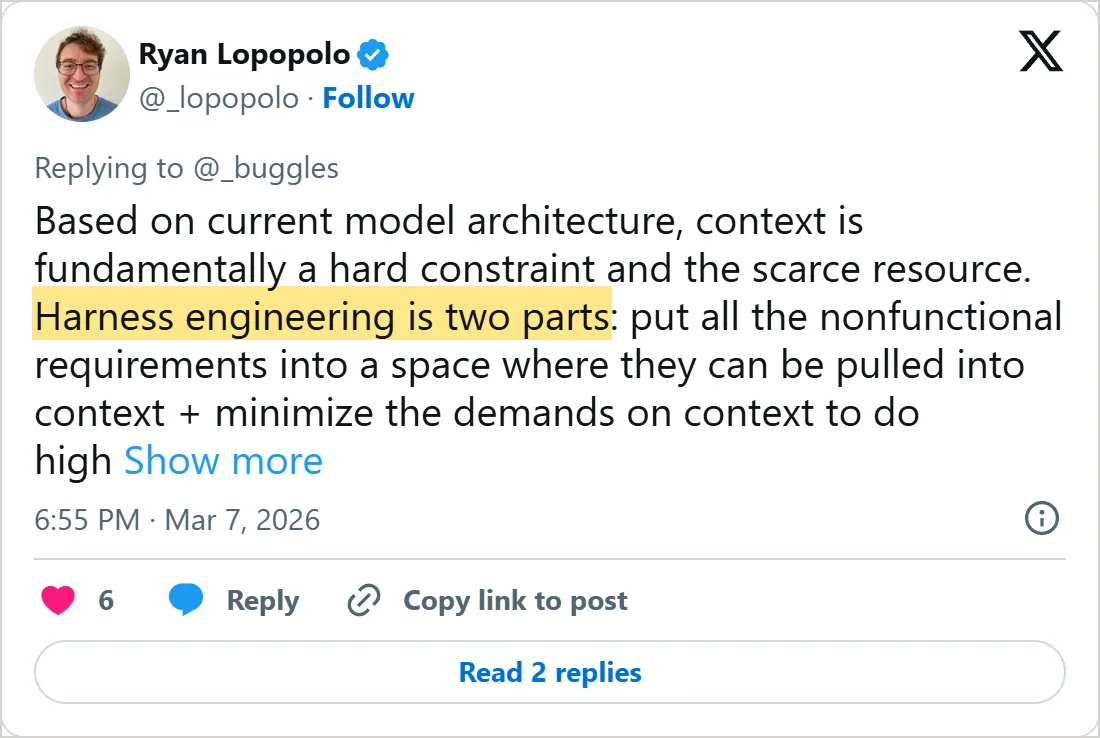
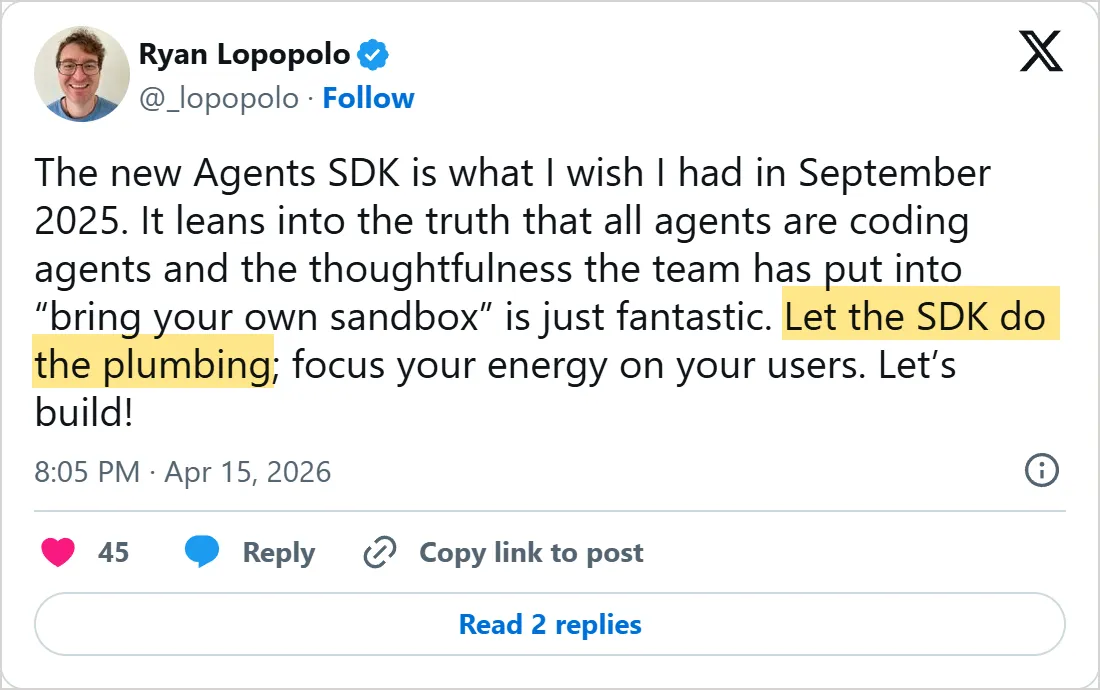

X 官方嵌入卡片的截图,拍摄于 2026 年 11 月 6 日,时间为 UTC。X 用“Show more”截断了第一条帖子。点击截图可到 X 上打开原帖。
常见错误
- 一边换 harness 一边比较两个模型。同一个模型在 Codex 里和在你的脚本里,看到的指令、工具和上下文都不一样。
- 把一个指令文件越写越长,直到它挤掉了任务本身,也没人分得清哪些规则还有效。
- 在对话中途增加工具或调换工具顺序,之后每次调用的缓存前缀都会失效。
- 以为一个沙盒管住了所有工具。在 Codex 里,它只管内置的 shell 工具,MCP 服务器要自己管自己。
- 规则只写在文字里,其实一条 lint 或一个测试就能在每次改动时强制执行。
- 需要某个变通办法的模型早已换掉,这个办法却还留在 harness 里。
动手试试
示意代码里的工具,是为读示例的人写的。下一课给 AI 智能体写工具,讲怎样为模型来写。
- 用示意代码自带的任务运行它,在提示处回答 n,看看模型在收到被拒绝的工具结果后,对用户说了什么。
- 把
MAX_TURNS设成 1,先问订单 O2 的状态,再要求取消它,记下是 harness 的哪个部分结束了这次运行。 - 打开你的
~/.codex/config.toml或项目里的AGENTS.md,在 Codex 那张表里标出哪些行已经由你掌控。 - 挑一条团队在代码评审里反复提的规则,把它写成一条 lint,让报错信息告诉智能体怎样改代码。
自测一下
在 Codex 的 harness 里,权限消息中的沙盒管的是哪些工具?
查看答案
B. 只有 Codex 自带的 shell 工具 沙盒只作用于 Codex 自带的 shell 工具,MCP 服务器提供的工具要自己负责安全护栏。
OpenAI 团队用什么替代了一个庞大的 AGENTS.md?
查看答案
A. 一份大约 100 行、指向 docs 文件夹的简短 AGENTS.md 大文件会挤掉任务并很快过时,所以它被改成一份目录,指向由 lint 保持更新的 docs 文件夹。
在 Codex 对话中途做哪种改动,会导致提示词缓存失效?
查看答案
C. 改变模型能用的工具 缓存命中需要完全相同的前缀,而工具列表位于每次请求的开头附近。
更强的模型发布了。Anthropic 那篇 harness 设计文章建议你怎样处理自己的 harness?
查看答案
D. 一次拆掉一个部件,再检查结果 每个部件都编码了一个关于模型做不到什么的假设,一次拆一个,才看得出哪些部件仍在承重。
常见问题
什么是 Harness 工程?
它指的是为编程智能体打造周边的一切,让它能可靠地完成工作。Ryan Lopopolo(OpenAI)在 2026 年 2 月发表的文章里用了这个说法。他团队里的工程师不亲手写代码,而是搭建智能体工作所依托的文档、lint 规则和反馈回路。
Claude Code 算是智能体 harness 吗?
算。里面的模型是 Claude,你在一次会话里遇到的其他一切,从权限提示到它开始时读取的 CLAUDE.md 文件,都属于 harness。所以同一个模型,在 Claude Code 会话里和在一次普通的 API 调用里,表现才会差这么多。
智能体 harness 和智能体框架是一回事吗?
不完全是。框架或 SDK 是别人写好、由你来配置的 harness。你自己在模型 API 外面写的循环也是 harness,只是更小,要你自己维护。
为什么同一个模型在两个编程智能体里表现不同?
因为每个 harness 围绕它拼出的请求都不一样。以 Codex 为例,它会在你的消息前面加上自己的指令、一条权限消息、AGENTS.md 文件和工作目录,而且每个智能体提供的工具也不相同。
安全护栏在 harness 里处在什么位置?
护栏就是每个动作前后的检查:沙盒、权限规则、审批提示和钩子。本课在 cancel_order 之前加的审批提示是最小的一种,其余的见智能体安全护栏那一课。
资料来源
- OpenAI: Harness engineering, leveraging Codex in an agent-first world https://openai.com/index/harness-engineering/
- OpenAI: Unrolling the Codex agent loop https://openai.com/index/unrolling-the-codex-agent-loop/
- Anthropic Engineering: Building effective agents https://www.anthropic.com/engineering/building-effective-agents
- Anthropic Engineering: Building agents with the Claude Agent SDK https://www.anthropic.com/engineering/building-agents-with-the-claude-agent-sdk
- Anthropic Engineering: Harness design for long-running application development https://www.anthropic.com/engineering/harness-design-long-running-apps
- Claude Cookbooks: Creating a customer service agent with client-side tools https://github.com/anthropics/claude-cookbooks/blob/main/tool_use/customer_service_agent.ipynb
- anthropic-sdk-python: ToolResultBlockParam (is_error) https://github.com/anthropics/anthropic-sdk-python/blob/main/src/anthropic/types/tool_result_block_param.py
- anthropics/claude-agent-sdk-python README https://github.com/anthropics/claude-agent-sdk-python
- openai/openai-agents-python README https://github.com/openai/openai-agents-python
- lopopolo/harness-engineering on GitHub https://github.com/lopopolo/harness-engineering
- Ryan Lopopolo on X: harness engineering is two parts https://x.com/_lopopolo/status/2030356581792293212
- Ryan Lopopolo on X: let the SDK do the plumbing https://x.com/_lopopolo/status/2044507506949689726
- AI Engineer on YouTube: Harness Engineering, Ryan Lopopolo https://www.youtube.com/watch?v=am_oeAoUhew