
语音平台对比:免费额度、价格和限制
大多数语音活,用下面八个平台就够了。ElevenLabs、OpenAI、Google 和微软在云端卖成品的声音和文字稿。Deepgram 和 AssemblyAI 面向做应用的人,卖语音识别和文字转语音,Deepgram 的识别按分钟计,AssemblyAI 的按音频小时计。Whisper 和 Kokoro 是免费模型,装在自己电脑上跑。
先看免费那一栏,再看价格。这些平台大多能让你在付钱之前,先听听自己的稿子读出来是什么效果,或者先转写一份自己的文件。各家的计量单位不一样,有积分、token、分钟,也有字符数,所以价格要放到你自己音频的长度旁边看才有意义。
| 平台 | 用来做什么 | 免费套餐 | 最低付费套餐(按官网写法) | 容易卡住的限制 | 能否商用 | API | 能否在自己电脑上运行 |
|---|---|---|---|---|---|---|---|
| ElevenLabs | 朗读文字、声音克隆、语音转文字(Scribe)、变声和语音智能体 | 每月 1 万积分,约十分钟文字转语音 | Starter:每月 $6,首月 $1,30,000 积分 | Starter 每月约 30 分钟语音。专业克隆从 Creator 套餐起 | Starter 及以上含商用许可,免费套餐没有列出 | 有 | 不能 |
| OpenAI API | 在自己的应用里做文字转语音、转写和实时语音智能体 | 定价页没有列出免费额度 | 按量付费:gpt-transcribe 每分钟 $0.0045,GPT-Live-1 每分钟 $0.05,gpt-4o-mini-tts 每 100 万音频 token $12 | 转写文件最大 25 MB。tts-1、tts-1-hd 和 gpt-4o-mini-tts 将于 2027 年 1 月 6 日停用。声音针对英语优化 | 使用政策要求告诉听众这是 AI 生成的声音 | 有 | 不能 |
| Google Gemini API | 一人或两人的文字转语音,声音复刻(即克隆,仅限付费层级),以及通过 Live API 的实时语音 | 免费层级里 Gemini 3.8 Flash TTS 和 Gemini 3.8 Live 都不收费 | 付费层级:Gemini 3.8 Flash TTS 输出每 100 万音频 token $9.00(到 2026 年 12 月 31 日),2027 年 1 月 1 日起 $18.00 | 每次请求最多两个说话人。免费层级的输入和输出可能被人工审阅 | API 条款写明 Google 不会主张对输出内容的所有权 | 有 | 不能 |
| 微软 Azure 语音服务 | 在企业应用里做语音转文字、神经网络文字转语音和个人声音 | 免费层(F0):每月 5 小时语音转文字,50 万字符神经网络文字转语音 | 官网页面未写明 | 个人声音和专业声音都要先经微软批准 | 官网页面未写明 | 有 | 不能 |
| Deepgram | 面向开发者的语音转文字、文字转语音和语音智能体 | $200 额度,不用绑卡,不会过期 | 按量付费:Nova-3 录音每分钟 $0.0043,实时每分钟 $0.0077,Aura-2 每 1,000 字符 $0.030 | 按量付费时最多同时 150 路实时语音转文字 | 官网页面未写明 | 有 | 不能 |
| AssemblyAI | 录音和实时音频的语音转文字,以及面向语音智能体的文字转语音(AssemblyAI-TTS-1) | $50 额度,不用绑卡 | 按量付费:Universal-3.5 Pro 每小时音频 $0.21,实时流每小时 $0.15 起,AssemblyAI-TTS-1 每 100 万字符 $15 | 免费层每分钟最多新开 5 路实时流。它的 Voice Agent API 正在下线 | 官网页面未写明 | 有 | 不能 |
| Whisper(OpenAI 开源) | 在自己电脑上做语音转文字 | 免费:代码和权重都用 MIT 许可证 | 无 | turbo 模型约需 6 GB 显存。不同语言的准确度差别很大 | MIT 许可证 | Python 库 | 能 |
| Kokoro-82M(开放权重) | 在自己电脑上朗读文字 | 免费:Apache 2.0 权重 | 无 | 8 种语言、54 个预设声音。页面没有介绍克隆功能,并说非英语的支持可能偏弱 | Apache 2.0,页面说可以用于生产环境 | Python 库 | 能 |
我们查阅时,Google Cloud 语音转文字的定价页没有显示任何数字,所以 Google 在这里以 Gemini API 的身份出现。
按你要做的事来挑
文字转语音是把你写的字读出来。语音转文字是把别人说的话记下来。声音克隆是照着某个真人的声音做一个副本,语音转语音则是把一段现成录音里的声音换掉。实时语音是和应用直接对话,不用等生成文件。
先认清手上是哪种活,再找对应的那一行。
- 免费试读一份稿子:ElevenLabs 免费套餐,或者 Google 免费层级里的 Gemini Flash TTS。Google 建议先在 AI Studio 里试听这些声音再动手开发,这一步不用写代码。
- 给要变现的频道配音:ElevenLabs Starter 或更高的套餐,这是第一档含商用许可的套餐。用 OpenAI 的声音时,还要告诉听众这是 AI 生成的。
- 会议或采访的文字稿:在自己电脑上跑 Whisper,按分钟算不花一分钱。用云端的话,gpt-transcribe、Deepgram Nova-3 和 AssemblyAI 按分钟或按小时收费,后两家注册就送额度。
- 克隆你自己的声音:ElevenLabs,即时克隆从 Starter 起,专业克隆从 Creator 起;也可以用付费层级的 Gemini API。
- 换掉一段录音里的声音:ElevenLabs 的 Voice Changer,每段最长 5 分钟,多语言模型支持 29 种语言。
- 在应用里做实时语音智能体:OpenAI 的指南建议新的对话类应用用 GPT-Live,它能边说边听。Gemini Live 在 Google 免费层级里不收费。Deepgram 则按分钟卖 Voice Agent API。
- 私密音频,或者没有网络:转写用 Whisper,朗读用 Kokoro,都在自己电脑上跑。再用 Ollama 跑一个本地文本模型来写稿,交给 Kokoro 去读。
- 中文语音或中文文字:Gemini 的文字转语音列出了简体、繁体两种中文,还有粤语。Kokoro 有 8 个普通话声音。转写方面,OpenAI 的 gpt-transcribe 接受分地区的中文语言代码。
- 给自己的应用接 API:表里每个云平台都有。OpenAI 的 API,我们的 OpenAI API 入门课会从申请密钥开始带你接通。
- 想听文档的语音摘要,而不是配音:这正是 NotebookLM 的音频概览根据你的文件做出来的东西。
来源:Google: Gemini API speech generation (2026年11月6日 查阅);OpenAI: Speech to text guide (2026年11月6日 查阅);Microsoft: What is personal voice? (2026年11月6日 查阅);ElevenLabs: Models (2026年11月6日 查阅);ElevenLabs: Voice changer (2026年11月6日 查阅);Hugging Face: hexgrad/Kokoro-82M (2026年11月6日 查阅)
克隆声音之前,各家要你做什么
声音克隆,就是根据某个人的录音,做出一个模仿他声音的模型。下面六项服务没有一项能跳过同意这一步,其中三家只对审核通过的客户开放。
在措辞上,OpenAI 和 Google 管得最严。说话人要大声读出一句固定的话,OpenAI 还说,只要和脚本有一点出入,这次尝试就会失败。下面是两家文档里的英文原句,录制时要照读英文:
OpenAI:I am the owner of this voice and I consent to OpenAI using this voice to create a synthetic voice model.
Google:I am the owner of this voice, and I consent to Google using this voice to create a synthetic voice model.| 服务 | 需要多少音频 | 同意这一步怎么做 | 谁能用 |
|---|---|---|---|
| ElevenLabs 即时克隆 | 建议 1 到 2 分钟干净的音频。Eleven v4 的发布文章说,用 10 秒音频就能捕捉一个声音 | 保存之前,你要确认自己有权利、也已获得同意去克隆这个声音 | Starter 及以上套餐 |
| ElevenLabs 专业克隆 | 最少 30 分钟,建议 2 到 3 小时 | 只能是你本人的声音,别人同意也不行。你要大声读出验证句来证明 | Creator 及以上套餐 |
| OpenAI 自定义声音 | 10 到 60 秒的录音,包含几个完整的句子 | 同一位说话人逐字读出上面的同意声明 | 符合条件的客户,通过 OpenAI 销售团队开通 |
| Google Chirp 3 即时自定义声音 | 最多 10 秒的单声道音频 | 说话人录下上面那句 Google 同意声明,不能自己改写 | 在白名单里的用户,通过 Google 销售团队开通 |
| Gemini API 声音复刻 | 一段 10 到 30 秒干净、自然的说话录音,外加一段同意录音,两段都来自同一位成年说话人 | 同一位说话人大声念出 Google 的同意声明,可用 30 种语言区域之一 | 付费层级(Tier 1 及以上)的 Gemini API 项目,不需要白名单 |
| 微软 Azure 个人声音 | 5 到 90 秒的语音样本 | 说话人录一段声明,承认这位 Azure 客户会创建并使用他的声音 | 经批准的客户和用途,通过申请表开通 |
开源模型不走这些流程。Resemble AI 的开源模型 Chatterbox 用一段参考音频就能克隆声音,并在每个文件里加上它的 Perth 水印。它的页面说,这个项目已在 2026 年 8 月停止维护。用开源模型时,征得同意完全是你自己的责任。
三步免费做出第一段配音
ElevenLabs 的免费套餐,让你在浏览器里不写代码,就能用几种声音听自己的稿子。下面的菜单名称都来自它的文字转语音指南。
每次生成都会扣积分,第一次试听也算。同样的文字、同样的声音和模型,两小时内、没刷新页面的话,可以免费重新生成两次。
- 打开 Text to Speech。在 elevenlabs.io 注册,在侧边栏选 Text to Speech,把稿子粘贴到输入框里。用 Eleven v4 一次最多一万个字符,其他模型五千个。
- 选声音和模型。在左下角的 Voices 里挑一个声音,再在模型选择器里选模型。用 Eleven v4 时,在稿子里写上 [laughs] 这类标签,就能指挥它的语气。
- 生成并下载。点 Generate speech 听一遍,再点右下角的下载按钮。想要 WAV 或其他格式,就打开右侧面板里的历史记录(history)标签页,点下载图标。可选 128 kbps 的 MP3 或 WAV,Advanced 里还有 192 或 256 kbps 的 MP3、M4A 和 FLAC。
用 Whisper 离线转写
Whisper 是 OpenAI 用 MIT 许可证发布的语音识别模型。它在你自己的电脑上运行,录音不会离开这台机器。你需要装好 Python 和命令行音频工具 ffmpeg(Windows 上用 choco install ffmpeg 或 scoop install ffmpeg,Mac 上用 brew install ffmpeg)。
下面这两行取自它的 README,先安装,再用 turbo 模型转写三个文件:
pip install -U openai-whisper
whisper audio.flac audio.mp3 audio.wav --model turboturbo 约需 6 GB 显存,而且没有训练过翻译,想把外语录音直接转成英文,就换一个尺寸。tiny 模型约需 1 GB,速度大约是 large 的十倍。能跑哪一个,取决于你的显卡,硬件这一课讲得很清楚。
ElevenLabs 和 OpenAI 开发者团队怎样指挥一个声音
2026 年 9 月 28 日,也就是 Eleven v4 发布当天,ElevenLabs 在 X 上发帖说,可以用行内标签来指挥它的表演。标签是写在稿子里、放在方括号中的一句简短指令。语气、情绪、节奏、反应、音效和风格都能这样设定,也可以直接描述某一句该怎么说。在第 2 步里试一下:同一句话加标签生成一次,不加再生成一次,哪一版读出了你想要的意思,就留哪一版。
OpenAI 的开发者账号更早一些,在 9 月宣布 GPT-Live-1 已经开放 API,用来做能边说边听的语音智能体。这一点只对实时语音有意义。录好的配音不会被人打断,打电话的人却会插话,所以试用智能体时,在它说到一半时插一句,看它会不会停下来听。
ElevenLabs 自己的 YouTube 频道上,有这两款新语音模型的发布视频。
创作者可以设定语气、情绪、节奏、反应、音效和风格,也可以直接描述某一句该怎么说
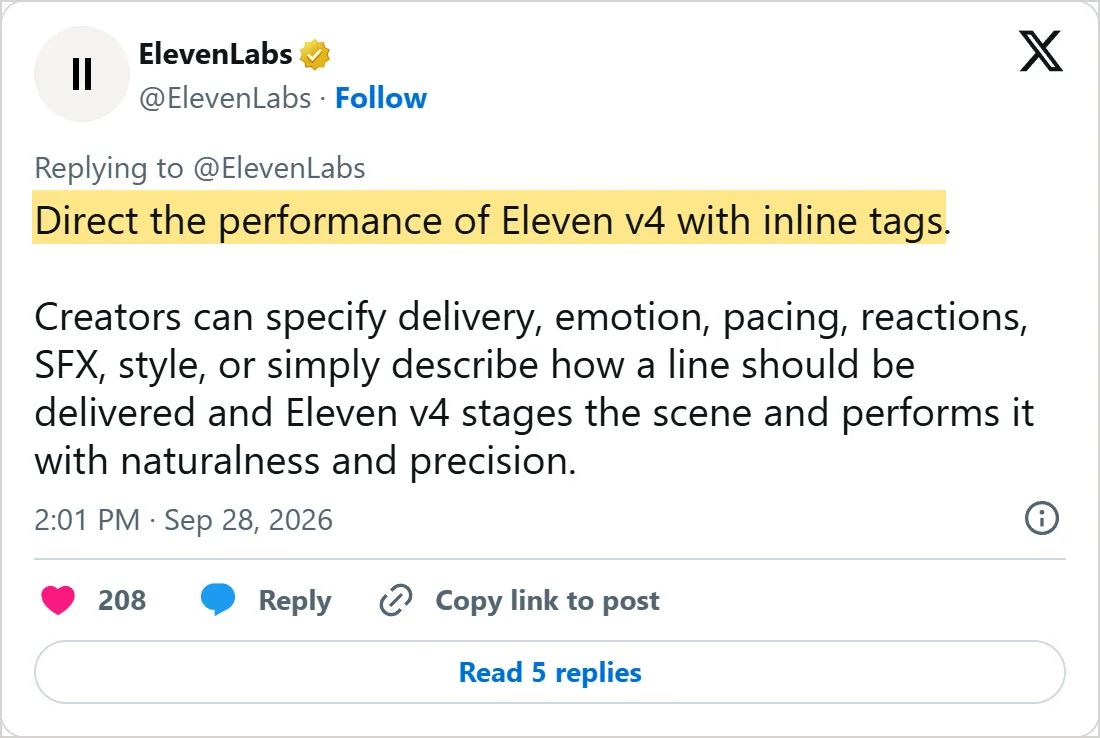
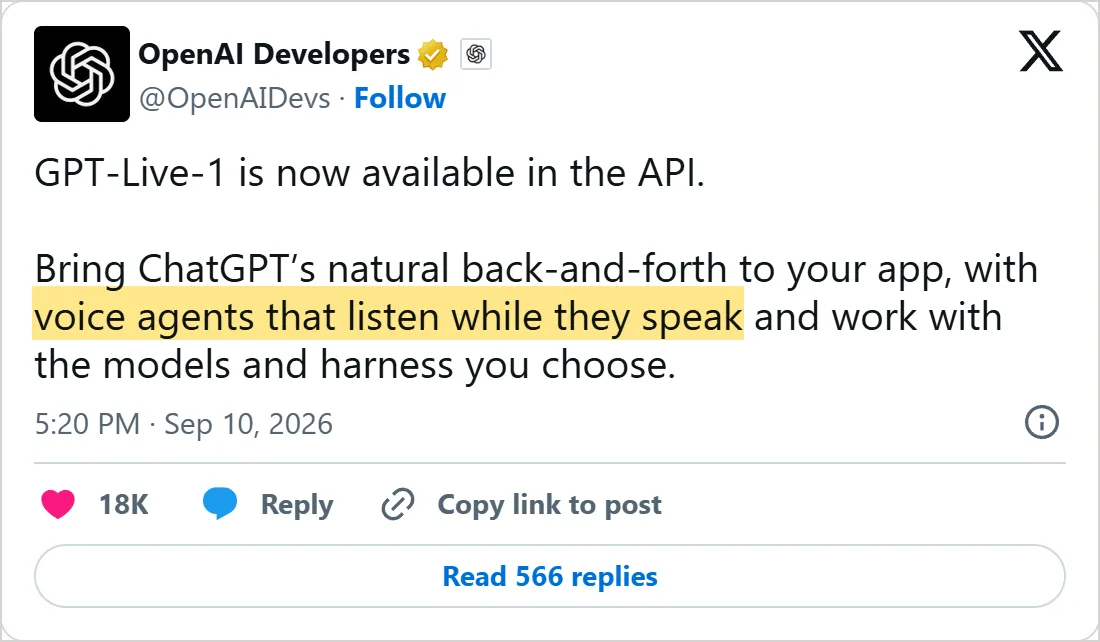
X 官方嵌入卡片的截图,拍摄于 2026 年 11 月 5 日,时间为 UTC。点击截图可到 X 上打开原帖。
常见错误
- 凭厂商的演示片段判断一个声音。把你自己的稿子贴进去,带上你的产品名和数字,因为它真正要读对的是这些。
- 新应用还在用 tts-1 或 gpt-4o-mini-tts 起步。它们会在 2027 年 1 月 6 日停用,OpenAI 让新项目改用 Realtime API 里的 gpt-realtime-2.1-mini,那是另一套工作流程。
- 把一整段长录音一次性发给 OpenAI 的转写接口。超过 25 MB 就太大了,先切开再传。
- 让保密的通话录音走 Gemini API 的免费层级。Google 说免费层级的输入和输出可能被人工审阅,这类录音用付费层级或本地模型。
自己试一试
- 把同一小段文字分别贴进 ElevenLabs 和 AI Studio 里的 Gemini 文字转语音,记下哪一个把你的产品名读对了。
- 用 Whisper 的 tiny 模型转写一段两分钟的语音备忘,再用 turbo 转写一次,把各自写错的词标出来。
- 在对比表里挑出你下一个项目会用的那一行,写下最可能卡住你的那个限制。
自测一下
你要用 ElevenLabs 给一个变现的频道配音,第一档列出商用许可的是哪个套餐?
查看答案
B. Starter ElevenLabs 定价页写明 Starter 及以上含商用许可,免费套餐没有列出。
朋友同意你用他的声音在 ElevenLabs 做专业克隆,结果会怎样?
查看答案
C. 会被拒绝,因为专业克隆只能是你本人的声音 ElevenLabs 文档说,专业克隆只能用你本人的声音,就算对方同意也不行。
哪个办法能转写一段保密录音,又不把它发到任何地方?
查看答案
A. 在自己电脑上运行 Whisper Whisper 在你自己的机器上运行,而所有云端方案都会收到这段音频。
你要用 OpenAI 做一个朗读文字的新应用,为什么不该基于 gpt-4o-mini-tts?
查看答案
D. 它将于 2027 年 1 月 6 日停用 OpenAI 的指南说 tts-1、tts-1-hd 和 gpt-4o-mini-tts 将于 2027 年 1 月 6 日停用,新项目改用 gpt-realtime-2.1-mini。
常见问题
AI 配音工具要花多少钱?
可以从零成本开始。ElevenLabs、Gemini API、Azure、Deepgram 和 AssemblyAI 都有免费额度或注册赠送的额度,Whisper 和 Kokoro 本身免费。付费套餐按积分、分钟或 token 计算,所以要拿你自己音频的长度去算价格。
AI 配音能用在 YouTube 上赚钱吗?
能,只要你生成时用的套餐允许商用,所以要看套餐,而不是看声音。在 ElevenLabs 上,任何一档付费套餐都符合。如果你把 OpenAI 的声音做进应用,它的政策要求向听众清楚说明。
最好的免费 AI 配音工具是哪个?
要看哪种限制你能接受。一份短稿子,ElevenLabs 每月的积分就够用。长篇有声书或者每天都要跑的活,更适合 Kokoro,它没有额度上限,也不用注册账号,只是只有 54 个预设声音。
用 AI 克隆别人的声音合法吗?
在这里列出的任何平台上,没有对方同意都不行,你所在地的法律可能还有更多要求。ElevenLabs 的专业克隆更严格,只接受你本人的声音,就算对方同意也不行。
哪个 AI 最适合把录音转成文字?
要在应用里做实时字幕,选 Deepgram 或 AssemblyAI,两家都卖流式语音转文字。要标出谁说了哪句话,OpenAI 的指南推荐 gpt-4o-transcribe-diarize,不过它将于 2027 年 2 月 26 日停用。私密文件还是交给 Whisper。
资料来源
- ElevenLabs: Pricing https://elevenlabs.io/pricing
- ElevenLabs: Models https://elevenlabs.io/docs/overview/models
- ElevenLabs: Text to Speech guide https://elevenlabs.io/docs/product-guides/playground/text-to-speech
- ElevenLabs: Instant Voice Cloning https://elevenlabs.io/docs/product-guides/voices/voice-cloning/instant-voice-cloning
- ElevenLabs: Professional Voice Cloning https://elevenlabs.io/docs/product-guides/voices/voice-cloning/professional-voice-cloning
- ElevenLabs: Voice changer https://elevenlabs.io/docs/overview/capabilities/voice-changer
- ElevenLabs: Introducing Eleven v4 https://elevenlabs.io/blog/eleven-v4
- OpenAI: API pricing https://developers.openai.com/api/docs/pricing
- OpenAI: Audio and speech guide https://developers.openai.com/api/docs/guides/audio
- OpenAI: Text to speech guide https://developers.openai.com/api/docs/guides/text-to-speech
- OpenAI: Speech to text guide https://developers.openai.com/api/docs/guides/speech-to-text
- OpenAI: Custom voices guide https://developers.openai.com/api/docs/guides/custom-voices
- Google: Gemini API speech generation https://aistudio.google.com/docs/speech-generation
- Google: Gemini API pricing https://aistudio.google.com/docs/pricing
- Google: Gemini API additional terms of service https://aistudio.google.com/docs/terms
- Google: Gemini API voice replication https://aistudio.google.com/docs/voice-replication
- Google Cloud: Chirp 3 Instant Custom Voice https://docs.cloud.google.com/text-to-speech/docs/chirp3-instant-custom-voice
- Microsoft: Azure Speech pricing https://azure.microsoft.com/en-us/pricing/details/cognitive-services/speech-services/
- Microsoft: What is personal voice? https://learn.microsoft.com/en-us/azure/ai-services/speech-service/personal-voice-overview
- Deepgram: Pricing https://deepgram.com/pricing
- AssemblyAI: Pricing https://www.assemblyai.com/pricing
- GitHub: openai/whisper https://github.com/openai/whisper
- Hugging Face: hexgrad/Kokoro-82M https://huggingface.co/hexgrad/Kokoro-82M
- Hugging Face: Kokoro-82M voices https://huggingface.co/hexgrad/Kokoro-82M/blob/main/VOICES.md
- GitHub: resemble-ai/chatterbox https://github.com/resemble-ai/chatterbox
- ElevenLabs (@ElevenLabs) on X: Eleven v4 inline tags https://x.com/ElevenLabs/status/2104572133636731068
- OpenAI Developers (@OpenAIDevs) on X: GPT-Live-1 in the API https://x.com/OpenAIDevs/status/2098099269551149398
- ElevenLabs on YouTube: Introducing Eleven v4 and Eleven v4 Turbo https://www.youtube.com/watch?v=th_tXR2QQ6U