
开始之前
你需要第 1 课的账号和令牌习惯,再加上 Python 3.10 或更高版本。这里的提供商是指在自己的服务器上运行模型、按请求收费的公司,比如 Groq、Together 或 Cerebras。Inference Providers 把其中 18 家放在同一个 Hugging Face 账号后面,你不用逐家注册。一个账号,一个令牌,一份账单。
这个名字容易让人糊涂。老教程管它叫 Hugging Face 推理 API,或者无服务器推理 API。无服务器是指你调用模型时,不用自己租用或运行服务器。原来那个服务以 HF Inference 的名字保留下来,和其他提供商一样。
从 2025 年 7 月起,HF Inference 主要提供适合在 CPU 上运行的模型。其中有嵌入模型,它把文字变成一串数字,方便搜索;还有文本分类器,以及 BERT、GPT-2 这类较老的小型大语言模型。大型对话模型则由合作提供商运行。用完包含的额度之后,HF Inference 按它硬件上的计算时间收费,而不是按 token。
各家提供商支持的任务并不相同。纯文字对话最常见。带图片的对话需要 VLM,也就是既能读文字、也能看图的视觉语言模型。嵌入、图片和视频生成、语音转文字,提供的家数都更少。表格列出了本课核对那天各家提供的任务,最新名单以概览页面为准。
为什么要调用托管模型?第 2 课已经说明了限制:模型必须装得进你的内存。下面的示例 openai/gpt-oss-120b 有 1200 亿个参数,笔记本远远装不下。交给提供商,只需要一次 HTTP 请求。不用下载,也不用 GPU。每次这样的调用都记在你的账号上,所以发完头几次请求后,去看看账单页面。
| 任务 | 提供这项任务的提供商 |
|---|---|
| 对话,文字进文字出 | Baseten、Cerebras、Cohere、DeepInfra、Featherless AI、Fireworks、Groq、HF Inference、Novita、Nscale、OVHcloud AI Endpoints、Public AI、Scaleway、Together、Z.ai |
| 带图片的对话(VLM) | Baseten、Cohere、DeepInfra、Featherless AI、Fireworks、Groq、HF Inference、Novita、Nscale、OVHcloud AI Endpoints、Together、Z.ai |
| 嵌入 | HF Inference、Scaleway、Together |
| 文字生成图片 | Fal AI、HF Inference、Nscale、Replicate、Together、WaveSpeedAI |
| 文字生成视频 | Fal AI、Novita、Replicate、Together、WaveSpeedAI |
| 语音转文字 | Fal AI、HF Inference、Replicate、Together |
创建令牌,发出第一个请求
最短的路是 huggingface_hub 里的 InferenceClient,也就是第 1 课用过的那个库。它会找到你保存的令牌,挑一个提供商,并按那家提供商要求的格式组织请求。下面的代码就是 Inference Providers 快速入门里发布的原样。它不需要 base_url,在已经登录的机器上也不需要传令牌。想在写代码之前用自己的提示词比较几个模型,可以打开 Inference Playground。
import os
from huggingface_hub import InferenceClient

client = InferenceClient()

completion = client.chat.completions.create(
    model="openai/gpt-oss-120b",
    messages=[
        {
            "role": "user",
            "content": "How many 'G's in 'huggingface'?"
        }
    ],
)

print(completion.choices[0].message)- 为这件事单独建一个令牌。在设置里创建一个细粒度令牌,勾选 Make calls to Inference Providers。只有这一项权限的令牌,只能调用模型,别的什么都做不了。
- 用
pip install huggingface_hub安装这个库。把令牌放进HF_TOKEN环境变量,或者像第 1 课那样用hf auth login --token $HF_TOKEN保存。 - 运行脚本。这里的
InferenceClient()不带任何参数:令牌来自你的环境变量或登录信息,提供商会自动选好。 - 看回复。
completion.choices[0].message里是回答的角色和文字,再取它的.content就只剩文字。finish_reason说明模型为什么停下,比如达到了max_tokens。completion.usage统计提示词、生成内容和总共的 token 数,提供商就是按 token 计费的。 - 让下一次回复流式输出。在调用里加上
stream=True,遍历它返回的内容,每到一块就打印它的chunk.choices[0].delta.content。 - 把
model字符串换成另一个 Hub id,比如deepseek-ai/DeepSeek-R1,再运行一次。id 要从模型的 Hub 页面复制,别从提供商自己的目录里抄。
用 OpenAI 客户端或纯 HTTP 调用
为 OpenAI 的 Python 客户端写的代码只需改两处。把 base_url 指向 https://router.huggingface.co/v1,再把 Hugging Face 令牌作为 api_key 传入。路由器是 Hugging Face 的一个端点,负责把每个请求转发给某家提供商。它使用 OpenAI 的对话格式,所以其余代码保持原样。
这个端点只处理对话。图片、嵌入和语音要走 InferenceClient,它为每种任务都准备了一个方法。文档里生成图片的示例,就是用 black-forest-labs/FLUX.1-dev 调用 text_to_image。
反过来也能换。InferenceClient 模仿了 OpenAI 的写法:client.chat.completions.create 是它自己的 chat_completion 的别名,api_key 和 base_url 分别是 token 和 model 的别名。把现有代码迁到 InferenceClient,只要改两行。
两个客户端接受同样的对话选项。max_tokens 限制回复长度,temperature 的取值是 0 到 2。stop 最多接受四个停止序列,seed 固定随机采样。tools 用来开启函数调用,也就是模型请你的代码去运行一个你描述过的函数;response_format 要求模型输出符合某个结构的 JSON。
加上 stream=True,模型写出一段,回复就到达一段。基于 asyncio 的代码可以用 AsyncInferenceClient,调用方式完全一样。生成图片时,text_to_image 返回一个图片对象,调用一次它的 save 方法就能存下来。
同一个客户端还能连你自己机器上的服务器。InferenceClient(model="http://localhost:8080") 会把对话请求发给任何兼容 OpenAI API 的本地服务器,比如 llama.cpp、vLLM、LiteLLM 或 TGI。数据不出你的电脑,也不产生费用,花额度之前拿它做测试很方便。
凡是要部署的脚本,都要设一个选项。默认情况下,InferenceClient 会无限期地等待回复。InferenceClient(timeout=30) 等 30 秒就放弃,并抛出 InferenceTimeoutError,你的代码可以捕获它再重试。这个时长对一段简短的对话回复够用,总结一份长文档可能需要更久,所以按任务分别设置。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-R1:fastest",
    messages=[{"role": "user", "content": "Hello!"}],
)

print(completion.choices[0].message.content)| 入口 | 要安装什么 | 支持的任务 | 怎样选提供商 |
|---|---|---|---|
InferenceClient | huggingface_hub | 对话、图片、嵌入、语音等 | provider="novita",或者在模型 id 后加后缀 |
| OpenAI 客户端 | openai | 只有对话,经过路由器 | 在模型 id 后加后缀,比如 :cheapest |
curl 或 requests | 不用额外安装 | 只有对话,经过路由器 | 在模型 id 后加后缀 |
挑选提供商,弄清谁向你收费
衡量一家提供商跑某个模型,看两个数字。吞吐量是它开始输出后每秒写多少个 token。延迟是你等到第一个 token 要多久。路由器的模型列表 GET /v1/models 在有数据时会报告这两个数字,还有每家的上下文长度。
不写提供商时,请求会交给服务这个模型最快的那家,按吞吐量来衡量。概览页面把这叫作 :fastest 策略。自动选择时,如果第一家被标记为不可用,请求还会转到另一家。这样一家公司出故障时,应用照样能回答,只是替补的回复速度可能不同。在 InferenceClient 里,同样的选择由 provider 参数决定,它的默认值是 "auto"。
有一个页面说法不同。huggingface_hub 的推理指南说,"auto" 会选你在 Inference Providers 设置页面里排在最前面的那家。本课核对资料的那天,这两个页面都还在线上。如果选择很重要,比如涉及合同、数据规定或稳定的延迟,就直接写明提供商,问题自然消失。固定下来只要一个后缀。
不是每个模型到处都有。hf models ls --warm 列出至少有一家提供商在服务的所有模型,加上 --json 方便脚本读取。
经由 Hugging Face 路由的请求,由 Hugging Face 按提供商的价格收费,每月额度会先抵扣。你也可以在 Inference Providers 设置里保存某家提供商自己的密钥。这样的调用由提供商直接收费,Hugging Face 的额度不算数。
在 Team 或 Enterprise 组织里,额度由全体成员共用,但请求只有写明组织时才会用到这些额度。每个人仍然用自己的令牌。给 InferenceClient 传 bill_to="my-org-name",或者在纯 HTTP 请求里带上 X-HF-Bill-To 请求头,这次请求就记到组织的账单上。Enterprise 组织还能通过一个 API 端点,按成员、模型和提供商拉取每天的用量,时间范围可以是过去 12 个月内的任意一段。
| 在模型 id 后加上 | 由哪家提供商回答 | 什么时候用 |
|---|---|---|
:fastest | 吞吐量最高的那家,按每秒 token 数计算。这是默认值 | 最看重速度 |
:cheapest | 每个输出 token 价格最低的那家 | 最看重成本 |
:preferred | 按你在设置页面排的顺序,第一家可用的 | 你已经自己给提供商排好了顺序 |
:groq、:together 或其他名字 | 只用那一家 | 每次调用都要同一家提供商 |
Célina Hanouti 谈在 VS Code 里用 Inference Providers
Célina Hanouti 是 Hugging Face 的工程师,也是 huggingface_hub 的共同维护者。她在 2025 年 9 月在 X 上宣布,Inference Providers 可以直接在 VS Code 的 GitHub Copilot Chat 里使用。这样 Qwen3-Coder、gpt-oss、GLM-4.5 这些开源模型就出现在编辑器的模型选择器里,背后是本课在 Python 里调用的同一批提供商。
设置页面要求 VS Code 1.104.0 或更高版本,并安装 HF Copilot Chat 扩展。打开聊天的模型选择器,点 Manage Models...,选 Hugging Face,粘贴你的令牌,再勾选想加入的模型。
同年 10 月底,她又在 X 上说,Copilot Chat 里的每个请求都可以交给最快或最便宜的提供商,和 :fastest、:cheapest 后缀是同一套策略。她的分法是:看重价格时选 cheapest,看重吞吐量时选 fastest。
对每个模型,你都可以在看重价格时明确选择“cheapest”
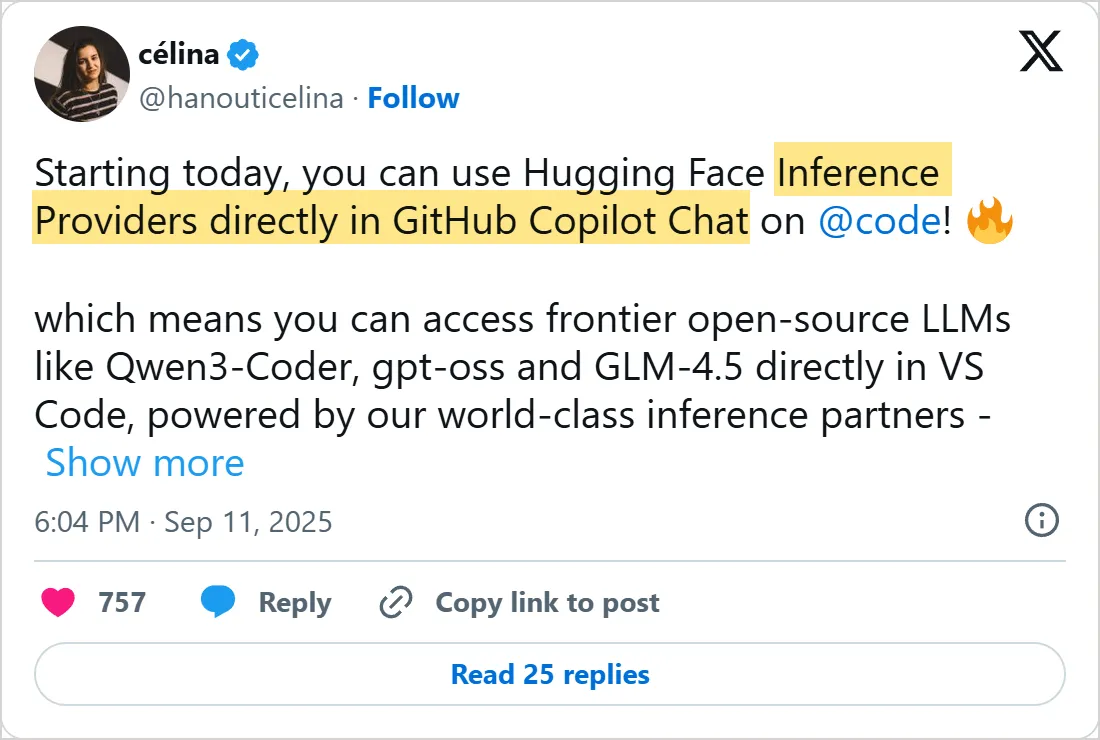
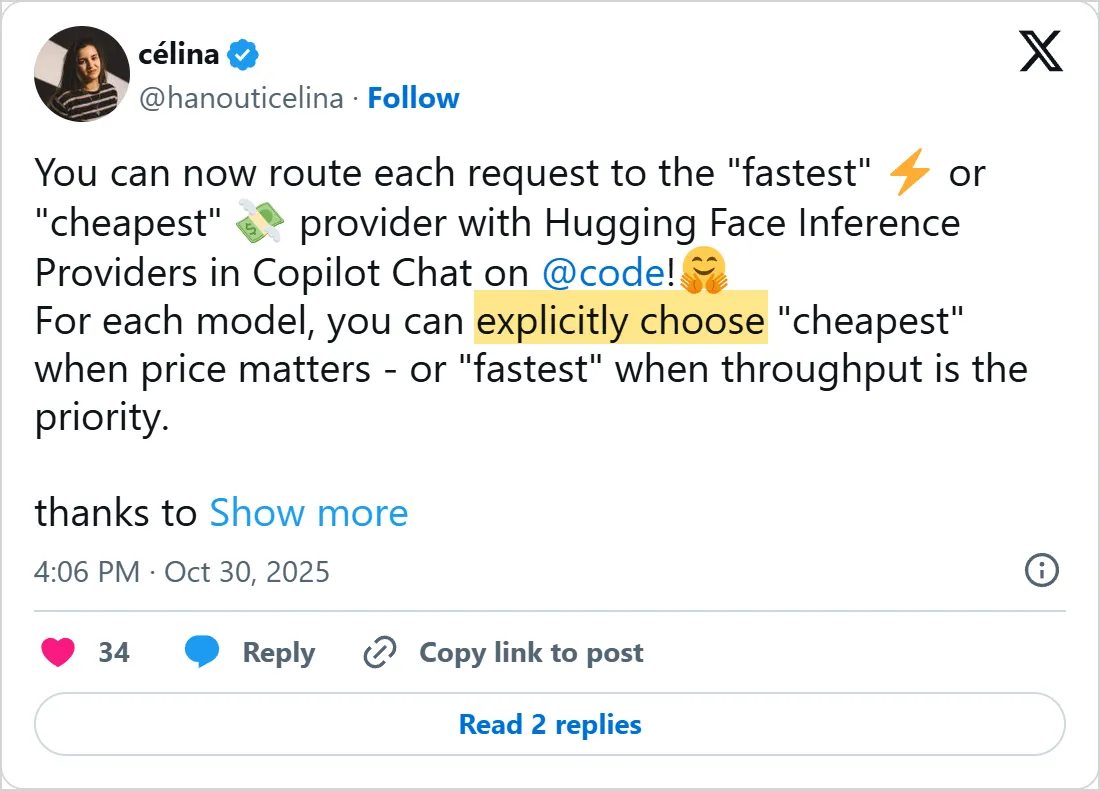
X 官方嵌入卡片的截图,拍摄于 2026 年 11 月 5 日,时间为 UTC。两条帖子都被 X 用“Show more”截断了。点击截图可到 X 上打开原帖。
常见错误
- 把令牌直接写进脚本。每个示例都从
HF_TOKEN读取,这样它不会进 git,也不会出现在截图里。 - 为每家提供商各写一个客户端。一个令牌、一个客户端就能用上所有提供商,换提供商只是一个参数或一个后缀。
- 用提供商自己的名字称呼模型。
model的值是 Hub id,比如openai/gpt-oss-120b,不管由哪家运行都一样。 - 把图片或嵌入请求发到路由器的网址。那个端点只处理对话,其他任务要走
InferenceClient。 - 给 OpenAI 客户端传
provider=。这个参数属于InferenceClient,在路由器上要靠模型 id 后面的后缀来选。 - 把
:cheapest当成质量设置。它只按每个输出 token 的价格给提供商排序,完全不涉及回复好不好。 - 在网页应用里不设超时。一旦某次调用卡住,就会一直占着一个工作进程。
- 不加后缀,却指望每次都是同一家提供商。自动选择会变,回复、速度和速率限制也会跟着变。
- 给同一个客户端同时传网址和提供商。两者互斥,因为网址会把客户端指向某一台服务器,比如你本机上 llama.cpp 或 vLLM 服务器的
http://localhost:8080。
自己试一试
这条 curl 命令是快速入门里的纯 HTTP 版本。照原样复制就行。它只需要终端里设好 HF_TOKEN,所以用它检查一个新令牌最快。
curl https://router.huggingface.co/v1/chat/completions \
    -H "Authorization: Bearer $HF_TOKEN" \
    -H 'Content-Type: application/json' \
    -d '{
        "messages": [
            {
                "role": "user",
                "content": "How many G in huggingface?"
            }
        ],
        "model": "openai/gpt-oss-120b:fastest",
        "stream": false
}'- 先运行一次,再把
:fastest改成:cheapest。回复或者等待时间有变化吗? - 把后缀换成概览合作伙伴列表里的一家,比如
:groq。如果那家不提供这个模型,会返回什么? - 把
"stream": true设上,看回复一段一段地到达。 - 运行
hf models ls --warm,从列表里挑一个更小的对话模型,问它同一个问题。 - 如果你属于某个 Team 或 Enterprise 组织,加上
-H "X-HF-Bill-To: my-org-name",换成组织的真实名字。这次请求记到了哪份账单上? - 请求
https://router.huggingface.co/v1/models,比较同一个模型在两家提供商那里的吞吐量和延迟。
接下来
现在你既能在自己的机器上运行模型,也能通过 API 调用更大的模型。但这两样都没法让别人试用你的成果。第 4 课把模型包进一个 Gradio 应用,发布成一个 Space,也就是任何人都能打开的页面。分享是最后一步。那个应用同样可以使用 InferenceClient,所以一个没有 GPU 的 Space 也能用大模型来回答。留好你在这里创建的令牌,Space 可以把它存成密钥。
自测一下
过去的无服务器推理 API 现在叫什么?
查看答案
D. HF Inference,提供商之一 这项服务改名为 HF Inference,如今和合作提供商并列。
发给提供商的模型 id 用哪一个?
查看答案
A. Hugging Face Hub 上的 id 发给提供商的请求用 Hub id 称呼模型,不管最后由哪家提供商运行。
在模型 id 后加上 :cheapest 会怎样?
查看答案
B. 选每个输出 token 价格最低的提供商 后缀决定提供商::fastest 看吞吐量,:cheapest 看每个输出 token 的价格。
InferenceClient 默认等多久的回复?
查看答案
C. 没有上限,直到你设置 timeout 它会无限期等待,所以部署的代码要传 timeout,并捕获 InferenceTimeoutError。
常见问题
Hugging Face 推理 API 免费吗?
免费账号用不了免费额度。免费用户没有每月额度,要买额度才能调用;PRO 账号以及 Team 或 Enterprise 组织每月都有额度。这些额度会在按量付费之前先抵扣,还能用于 Spaces 硬件、Inference Endpoints 和 Jobs。
Inference Providers 和 Inference Endpoints 有什么区别?
Inference Providers 是许多客户共用的托管模型,按请求收费。Inference Endpoints 是 Hugging Face 的另一项服务,把模型部署在专门留给你的硬件上。InferenceClient 两者都能调用。流量稳定,或者模型没有任何提供商在服务时,适合用 Endpoint;其余情况用共享的提供商就好。
能在 JavaScript 里用 Inference Providers 吗?
可以。安装 @huggingface/inference,用你的令牌创建一个 InferenceClient;或者把 openai 的 JavaScript 包指向路由器的网址。请求的结构和 Python 版本一样,JavaScript 客户端也接受同样的 provider 选项。
能给 Inference Providers 的花费设上限吗?
组织可以。Team 和 Enterprise 的管理员能在组织设置里设定支出上限,并关闭不想用的提供商。价格页面没有提到个人账号的上限,所以要在账单页面盯着用量,并把 max_tokens 设得适中。
资料来源
- Inference Providers overview https://huggingface.co/docs/inference-providers/index
- Inference Providers: Pricing and billing https://huggingface.co/docs/inference-providers/pricing
- Inference Providers: Chat completion https://huggingface.co/docs/inference-providers/tasks/chat-completion
- huggingface_hub: Run inference on servers https://huggingface.co/docs/huggingface_hub/guides/inference
- Hugging Face Hub: User access tokens https://huggingface.co/docs/hub/security-tokens
- Hugging Face: Inference Playground https://huggingface.co/playground
- Inference Providers: Use them with GitHub Copilot Chat in VS Code https://huggingface.co/docs/inference-providers/integrations/vscode
- Célina Hanouti on X: Inference Providers in GitHub Copilot Chat https://x.com/hanouticelina/status/1966201072390701298
- Célina Hanouti on X: fastest or cheapest provider in Copilot Chat https://x.com/hanouticelina/status/1983928520674852902