
开始之前
你需要一个终端、能下载文件的网络,以及足够的硬盘空间。开放模型指的是权重可以下载、可以自己运行的模型。权重就是保存模型所学内容的大文件,硬盘主要就是被它们占满的。
Ollama 本身在 Windows 上至少要 4GB 空间,Windows 页面还提醒,模型可能再占用几十到几百 GB。
有显卡更好,但不是必需的。快速入门里的第一个模型,建议有大约 8 GB 空闲显存,也就是显卡上的内存,Mac 上则是同样多的统一内存。显存不够时,Ollama 会把一部分模型放进系统内存,回答会变慢。哪种模型适合你的电脑,第 4 课会算给你看。
用本地模型不需要账号。第一次启动时会提示登录,那是给云端模型用的。云端模型在 ollama.com 上运行,用代码调用时还要 API 密钥。
如果是没有桌面的服务器,Ollama 也在 Docker Hub 上发布了官方镜像 ollama/ollama。
对照各平台页面检查一下你的系统:
- Windows 10 22H2 或更新版本,家庭版或专业版。NVIDIA 显卡要 551.61 或更新的驱动,AMD 显卡要 ROCm v7 驱动,或者支持 Vulkan 的 Radeon 驱动。
- macOS Sonoma(14)或更新版本。Apple M 系列芯片的 Mac 用 CPU 和 GPU 运行模型,Intel 芯片的 Mac 只用 CPU。
- Linux 需要有
curl来运行安装脚本。NVIDIA 显卡要求计算能力 5.0 或以上,驱动 550 或更新。
在 Windows、macOS 和 Linux 上安装 Ollama
Ollama 建立在 llama.cpp 之上,这个开源引擎也是 LM Studio 运行 GGUF 模型文件的方式,所以这里学到的模型文件知识,换个工具照样用得上。
不管用哪个系统,ollama 命令都是在和你本机上的一个小服务器通信,地址是 127.0.0.1:11434。
在 Windows 和 macOS 上,桌面应用会替你运行这个服务器。在 Linux 上,它作为 systemd 服务运行,或者在终端里用 ollama serve 启动。
最快的安装方式只要一行命令。macOS 和 Linux 用同一个 shell 脚本,Windows 用一行 PowerShell,都出自 Ollama 的 README:
# macOS or Linux
curl -fsSL https://ollama.com/install.sh | sh

# Windows, in PowerShell
irm https://ollama.com/install.ps1 | iex

# then, in a new terminal
ollama -v- Windows:运行那行 PowerShell,或者下载 OllamaSetup.exe 并运行。它装在你的用户账号下,不需要管理员权限。想装到别的盘,就用
OllamaSetup.exe /DIR="d:\some\location"启动安装程序。 - macOS:运行脚本,或者打开 ollama.dmg,把 Ollama 拖进“应用程序”。应用第一次启动时,允许它在
/usr/local/bin里创建链接,不然终端找不到ollama。 - Linux:运行脚本。想手动安装的话,Linux 页面的做法是把
ollama-linux-amd64.tar.zst解压到/usr,再建一个带专用ollama用户的 systemd 服务。 - 仅限 Linux:如果之后的命令连不上服务器,用
sudo systemctl start ollama启动服务,或者在另一个终端里运行ollama serve,并让那个窗口一直开着。
想把 Ollama 作为 Windows 服务运行,Windows 页面提供了 ollama-windows-amd64.zip,里面只有命令行程序和 NVIDIA 的库,再用 NSSM 这类服务包装工具运行 ollama serve。
一步步操作(附截图)
按顺序走一遍第一次使用的过程,从查看版本到卸载模型。截图是这些命令在一台 Windows 电脑上打印出来的结果。
打开一个新终端,运行
ollama -v。打印出版本号,就说明 Ollama 已经装好,终端也找得到它。
先运行
ollama pull gemma4:e2b下载本课的模型,大约 7.2 GB,再运行ollama ls列出硬盘上的模型。截图里的电脑已经装了qwen2.5:7b,所以截图用的是它。截图里写qwen2.5:7b的地方,你换成gemma4:e2b就行。
运行
ollama run gemma4:e2b "Why is the sky blue?",不打开对话,只问一个问题。第一次回答要等一会儿,Ollama 得先把模型载入内存。不写带引号的提示词,就会进入>>>对话提示符。
马上运行
ollama ps,它列出内存里的模型。第四列说明每个模型跑在哪里,这里写的是96%/4% CPU/GPU,也就是模型大部分在系统内存里。最后一列倒数 Ollama 什么时候把它卸载。
用
ollama stop gemma4:e2b释放内存,它什么都不打印。再运行一次ollama ps,只剩表头一行,说明没有模型在内存里了。
Ollama 0.40.14 在 Windows 上的真实输出,放进终端画框里展示,拍摄于 2026 年 11 月 6 日。
下载模型并和它对话
两条命令就能让模型开口。ollama pull 负责下载,ollama run 把模型载入内存,并在终端里打开对话。
快速入门用的是 gemma4:e2b,它是 Gemma 4 的小型版本之一,下载大约 7.2 GB。
冒号后面的部分叫标签。一个模型名下有好几种大小和变体,标签用来选其中一个。Ollama 模型库里的 gemma4 页面列出了这些标签和各自的大小,从 e2b 一直到 31b。只写 gemma4 这样的名字,指的是页面标为 latest 的那个标签。
不同标签的大小差别很大,这一节末尾的图表就能看出来,所以拉取之前先看一眼大小那一列。
模型载入后,你会看到 >>> 提示符。输入问题,按回车。要粘贴多行文字,就像 CLI 参考里那样,用三个双引号把它包起来。输入 /bye 结束对话。
在模型名后面加一段带引号的提示词,就会跳过对话,直接打印一个回答,写脚本时很方便。
换成能看图的模型,同样的写法还能读图片:把文件路径写进提示词里。CLI 参考给的例子是 ollama run gemma4 "What's in this image? /Users/jmorgan/Desktop/smile.png"。
并不是每个模型都输出文字。嵌入模型会把文字变成一串数字,供搜索工具做比较。运行 ollama run embeddinggemma "Hello world",打印出来的就是这样一个 JSON 数组。
结束对话并不会释放内存。模型在最后一次请求之后会继续驻留 5 分钟,这样下一次提问就不用重新载入。OLLAMA_KEEP_ALIVE 可以统一改这个等待时间。想提前把模型载入,就用空提示词运行它:ollama run gemma4:e2b ""。
只输入 ollama、后面什么都不加,会打开一个菜单。它会提议运行一个模型,或者把本地模型交给你已经在用的工具。
菜单背后是 ollama launch,它会配置并启动 OpenCode、Claude Code、Codex、VS Code 或 Droid,让它们改用你自己的服务器。在项目目录里运行,比如 ollama launch claude,按提示选一个模型即可。
加上 --model gemma4:e2b 可以跳过选择,加上 --config 则只写入设置,不启动工具。
ollama pull gemma4:e2b
ollama run gemma4:e2b

# one prompt, one answer, no chat
ollama run gemma4:e2b "Why is the sky blue?"来源:Ollama library: gemma4 (2026年11月5日 查阅)
管理模型,找到它们的存放位置
有两张列表能告诉你 Ollama 手里有什么。ollama ls 列出硬盘上的所有模型,ollama ps 列出已经载入内存的模型。电脑变慢的时候,先看后者。
内存比想象中满得快。默认情况下,Ollama 每块 GPU 最多同时载入三个模型,没有 GPU 的机器也是三个。试了一下午模型,内存里可能同时躺着好几个。ollama stop 能马上卸载其中一个。
在 ps 的输出里,PROCESSOR 列说明模型放在哪里,CONTEXT 列说明模型能容纳多少 token 的对话。token 是一小段文字,常常是半个词。上下文越长,占的内存越多,所以短上下文时装得下的模型,换成长上下文就可能溢出。
删除是不可逆的。用 ollama rm 删掉的模型,下次要用还得重新拉取,整个文件再下载一遍。
模型文件在每台电脑上放在同一个目录里。想挪到更大的硬盘,就把 OLLAMA_MODELS 设成新目录,然后退出并重启 Ollama,让它读到这个变量。
在 Windows 上,卸载程序不会删掉挪走的目录,卸载 Ollama 之后要自己删除。
Ollama 的其他文件放在别处。在 Windows 上,程序本身在 %LOCALAPPDATA%\Programs\Ollama,日志和下载好的更新在 %LOCALAPPDATA%\Ollama。出问题时,服务器日志通常会写明原因:Windows 上打开那个目录里的 server.log,Linux 上运行 journalctl -e -u ollama。
ollama ls                 # models on disk
ollama ps                 # models in memory, with PROCESSOR and CONTEXT
ollama stop gemma4:e2b    # unload it now
ollama rm gemma4:e2b # delete it from disk100% GPU:整个模型都在显存里,这也是它跑得最快的情况。100% CPU:模型完全在系统内存里运行。48%/52% CPU/GPU:显卡装不下整个模型,有一部分放在系统内存里。换一个更小的标签,或者缩短上下文,就可能回到100% GPU。
| 系统 | 默认模型目录 | 在哪里设置 OLLAMA_MODELS |
|---|---|---|
| macOS | ~/.ollama/models | Ollama 以应用方式运行时,用 launchctl 设置 |
| Linux | /usr/share/ollama/.ollama/models | 在 systemd 服务里用 systemctl 设置,ollama 用户要对新目录有读写权限 |
| Windows | C:\Users\%username%\.ollama\models | 在你账号的环境变量里设置,然后退出并重新打开托盘应用 |
Ollama 官方账号怎样发布一个新模型家族
Ollama 的账号三月在 X 上宣布了 Qwen 3.5 小模型系列,帖子列出一串 ollama run 命令,每个尺寸一行:qwen3.5:9b、4b、2b 和 0.8b。
帖子说,这些模型在 Ollama 里都支持工具调用、思考和图片输入。
这些正是本课用过的 run 命令,所以新模型一进模型库,就只差一行命令。模型库页面至今仍列着这四个尺寸,9b 是 latest 标签,0.8b 的下载只比一 GB 多一点。
想在配置一般的电脑上试试这个家族,就从 ollama run qwen3.5:0.8b 开始。只要 ollama ps 还显示 100% GPU,就往上换一个尺寸,遇到第一个溢出到系统内存的就停下。想看桌面应用本身的介绍,可以看下面 Sam Witteveen 的视频。
所有模型在 Ollama 里都支持原生工具调用、思考和多模态能力。
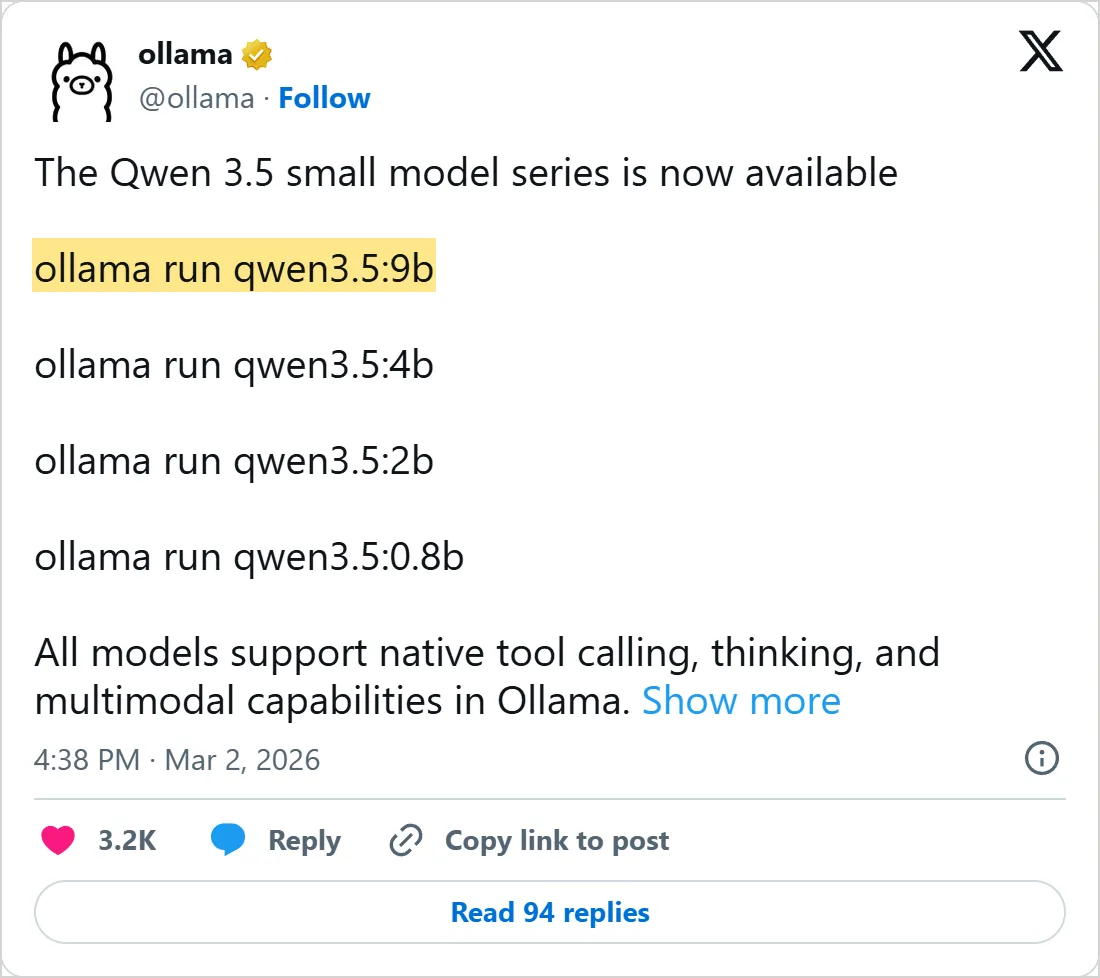

X 官方嵌入卡片的截图,拍摄于 2026 年 11 月 5 日,时间为 UTC。点击截图可到 X 上打开原帖。
常见错误
- 一上来就拉最大的标签。模型装不进显存,就有一部分在系统内存里运行,每个回答都会变慢。先从小的开始,再往上换。
- 用默认上下文去处理一份长文档。显存不到 24 GiB 时,Ollama 给每个模型留 4k token 的上下文,而它的上下文页面建议,智能体和编程工具至少要 64000。在应用设置里拖动滑块,或者用
OLLAMA_CONTEXT_LENGTH调大。 - 在某个终端里设置了
OLLAMA_MODELS或OLLAMA_HOST,而应用或服务还在用旧的环境。改了任何变量,都要重启 Ollama。 - 用
OLLAMA_HOST=0.0.0.0:11434把服务器开放到网络上,却没配防火墙规则。本地请求不需要 API 密钥,谁能连上这个端口,谁就能用你的模型和显卡。 - 想用本地模型,却选了云端模型。云端模型要先
ollama signin,在 Ollama 的服务器上运行,FAQ 说发给它们的提示词会在那里处理。对本地模型,FAQ 的说法是 Ollama 看不到你的提示词和数据。 - 把 Windows 独立版的压缩包直接解压到旧版本上。Windows 页面要求升级前先删掉旧目录。
- 关掉对话,就以为内存马上回来了。模型会一直驻留到保活时间结束,所以开游戏或导出视频之前,先运行
ollama stop。
自己试一试
- 拉取同一个模型的两个标签,运行
ollama ls,比较它们在硬盘上的大小。 - 问一个问题,马上运行
ollama ps,六分钟后再运行一次。模型有没有按时离开列表? - 挪动模型目录:设置
OLLAMA_MODELS,重启 Ollama,拉一个小模型,看新目录有没有文件进来。 - 运行
ollama serve --help,找出设置服务器监听地址的那个变量。 - 给能看图的模型一个截图路径,写在提示词里,问它窗口里显示的是什么。
- 重启 Ollama,连续发两个提示词并计时。哪一个在等模型载入?
- 用
ollama rm删掉测试用的模型。ollama ls里还有它们吗?
接下来:这一课的每条命令都经过本机服务器,你自己的程序也可以这样用它。第 2 课会用 curl 和 Python 给它发提示词,做流式输出,还会让 OpenAI SDK 改连你的电脑,而不是云服务。如果你是为了隐私而来,入门课程里的 AI 隐私那一课讲了托管的聊天应用会保留你对话里的哪些内容。
自测一下
哪条命令能显示此刻载入内存的模型?
查看答案
B. ollama ps ollama ps 列出正在运行的模型,带 PROCESSOR 和 CONTEXT 两列,ollama ls 列出的是硬盘上的模型。
想把模型文件放到更大的硬盘上,该设置什么?
查看答案
C. OLLAMA_MODELS OLLAMA_MODELS 指定存放模型的目录,Ollama 重启后会读取它。
PROCESSOR 列显示 48%/52% CPU/GPU,这是什么意思?
查看答案
A. 显卡装不下整个模型,有一部分在系统内存里 出现比例说明模型一部分载入了显卡,一部分在系统内存里。
在 Linux 上,ollama run 连不上服务器,先试什么?
查看答案
D. 用 ollama serve 或 systemd 服务启动服务器 命令是和本机服务器通信的,在 Linux 上要用 ollama serve 或 systemctl 把它启动。
常见问题
Ollama 能离线使用吗?
能,前提是模型已经下载到硬盘上。拉取模型需要联网,macOS 和 Windows 上的桌面应用有网时也会自己下载更新,但本地模型在断网时照样能回答。云端模型例外,它们在 ollama.com 上运行。
怎样更新 Ollama?
桌面应用(Mac 版和 Windows 版)会自动下载新版本。Linux 版没有自动更新,要手动升级,办法是重新运行一遍安装那一步里的 curl 单行命令。
能用 Ollama 运行 Hugging Face 上的模型吗?
能。让 ollama run 指向 hf.co/{username}/{repository},Hub 上任何 GGUF 仓库都行,再加上 :Q8_0 这样的标签来选量化版本。不加标签时,如果仓库里有 Q4_K_M,Ollama 就用它。这些名字是什么意思,第 4 课会讲。私有仓库也能用,只要把 ~/.ollama/id_ed25519.pub 里的公钥作为 SSH 密钥加到你的 Hugging Face 账号上。
怎样卸载 Ollama?
在 Windows 上,到“添加或删除程序”里卸载。在 macOS 上,删掉应用、/usr/local/bin/ollama 链接、~/.ollama 目录,以及 macOS 页面列出的几个缓存目录。在 Linux 上,先停止并禁用服务,再删除程序文件、它的库和 /usr/share/ollama。
资料来源
- Ollama Docs: Quickstart https://docs.ollama.com/quickstart
- Ollama Docs: Windows https://docs.ollama.com/windows
- Ollama Docs: macOS https://docs.ollama.com/macos
- Ollama Docs: Linux https://docs.ollama.com/linux
- Ollama Docs: CLI reference https://docs.ollama.com/cli
- Ollama Docs: FAQ https://docs.ollama.com/faq
- Ollama Docs: Hardware support https://docs.ollama.com/gpu
- GitHub: ollama/ollama https://github.com/ollama/ollama
- Ollama library: gemma4 https://ollama.com/library/gemma4
- Hugging Face Docs: Use Ollama with any GGUF model on the Hub https://huggingface.co/docs/hub/ollama
- Ollama library: qwen3.5 https://ollama.com/library/qwen3.5
- Ollama on X: the Qwen 3.5 small model series is now available https://x.com/ollama/status/2028510184788926567
- Sam Witteveen on YouTube: Ollama Gets a New App https://www.youtube.com/watch?v=xN4Q98CbqqE