
开始之前
你需要一个免费的 Hugging Face 账号、Python 3.10 或更高版本,以及一个终端。第 2 课要求 Python 3.11,这是 Transformers 测试过的最低版本,所以建一个 3.11 的环境就能学完整门课。
有了账号,才能申请受限模型、创建访问令牌,并拿到更高的下载额度。Hub 上的一切都放在仓库里。仓库就是带版本管理的文件夹,有提交记录和分支,和 GitHub 仓库很像。huggingface_hub 库负责从 Python 读写这些仓库,同时自带 hf。它是一个命令行工具,也就是靠输入命令来操作的程序。如果你只想要命令行工具,安装页面还为 macOS、Linux 和 Windows 提供了独立安装程序。
老教程里还写着 huggingface-cli login。Hugging Face 在 2025 年 7 月把这个工具改名为 hf,v1.0 迁移指南写明旧名字已经移除。现在的命令按“资源,再动作”的顺序写:hf auth login、hf cache ls。下载和上传仍然放在顶层,分别是 hf download 和 hf upload。老教程还可能让你设置 HF_HUB_ENABLE_HF_TRANSFER 来加速下载。同一个版本也会忽略这个变量,因为现在的速度来自 hf_xet 包,从 0.32.0 版起它就随 huggingface_hub 一起安装。
一个模型仓库通常放着三类文件。config.json 描述模型的结构。分词器文件描述分词器,它把文字切成一个个带编号的小片段,这些片段叫 token,是模型读取的单位。权重文件存放权重,也就是模型计算时用到的那些学出来的数字,下载量几乎全在这里。
Windows 上的下载缓存依赖符号链接,也就是指向另一个文件的文件条目。在 Windows 设置里打开开发者模式,或者用管理员身份运行 Python。两样都不做,缓存照样能用,只是会以安装页面所说的“非优化”方式运行。
一步步操作(附截图)
这六步不需要账号,从模型列表一路走到受限模型,每一步都配了一张网站的截图。
打开 huggingface.co/models。在 Tasks(任务)下点 Text Generation(文本生成),再打开 Sort(排序)选 Most downloads(下载最多)。列表里只剩文本生成模型,下载最多的排在最前面。

在页面顶部的搜索框里输入
gpt2,下方会弹出匹配的模型菜单,openai-community/gpt2排第一。点开它。
打开后就是这个模型的模型卡。模型名下面的标签写着它的任务、能加载它的库和许可证。用任何模型之前,先找到 License(许可证)标签,这个模型写的是
mit。
点 Model card(模型卡)旁边的 Files and versions(文件和版本,窗口窄时只显示 Files)。这里就是仓库本身:
config.json只有 665 字节,存的是设置,model.safetensors存权重,大小 548 MB。其他几个大文件是同一个模型为别的工具另存的版本。
回到 Model card,点 Use this model(使用此模型)。菜单里 Libraries 下有 Transformers,Notebooks 下有 Google Colab 和 Kaggle,Local Apps 下有 vLLM 这类本地应用。

有些模型要先同意条款。不登录,直接打开 google/gemma-2-2b,页面上的方框写着必须接受条件才能访问文件,方框底部有 Log in(登录)和 Sign Up(注册)两个按钮。

huggingface.co 截图,拍摄于 2026 年 11 月 6 日。
找到模型,读懂模型卡
从模型页面开始,先选一个任务筛选,比如文本生成或文本分类。Hub 上有超过 2M 个模型、1.5M 个数据集和 1.5M 个 Spaces,Spaces 是它对托管演示应用的叫法。先按任务筛,再按许可证筛,还没点开任何页面,列表就短了很多。第 2 课会把同一个任务名交给 pipeline()。
每个模型页面都会把仓库里的 README.md 显示成模型卡:顶部是一段 YAML,下面是 Markdown 正文。YAML 是一种纯文本格式,每行写成 key: value。许可证徽章、任务标签,以及你刚才用过的筛选器,全都来自这段元数据。两个模型看起来差不多时,先比较这两段元数据。如果模型是你自己的,页面上的 Edit model card 按钮可以通过表单修改同一段元数据。
许可证列表里既有 apache-2.0、mit 这样的软件许可证,也有 llama3.1、gemma 这样的模型许可证,还有 cc-by-nc-4.0 这种禁止商用的许可证。模型卡也可以写 license: other,再指向自定义条款。徽章只告诉你是哪种许可证,判断不了你的用法是否合规,所以模型要进入任何收费产品之前,先把条款读完。
模型卡还提供另外两种筛选:训练数据集和基础模型。基础模型是另一个模型的出发点。别人会对它做微调,也就是用新数据继续训练;或者做量化,用更少的位数存放它的数字,让它占用更少内存。按基础模型筛选,会列出从它衍生出的所有版本。想找一个你喜欢的模型的小号版本,就这么找。
不开浏览器也能读元数据。这个库自带的安装检查命令会打印模型的标签和任务。文档里用 gpt2 跑的示例中,标签里有 license:mit,任务是 text-generation。
python -c "from huggingface_hub import model_info; print(model_info('gpt2'))"| 模型卡字段 | 里面写的是什么 | 对你有什么影响 |
|---|---|---|
license | 许可证 id,显示成徽章,许可证筛选器也用它 | other 表示自定义条款,名称写在 license_name,链接写在 license_link |
pipeline_tag | 任务,比如 text-generation | 决定页面上的小组件,以及哪些推理接口为这个模型服务 |
library_name | 加载它的库,比如 transformers | 2024 年 8 月之后创建的仓库必须写明,只有 config.json 已经不会被默认当成 Transformers |
base_model | 一个或多个上游模型,写的是 Hub id | 按基础模型筛选时,它会出现在上游模型名下 |
datasets | 训练用的数据集,写的是 Hub id | 页面上会多一行“Datasets used to train”,并附上链接 |
new_version | 取代它的新模型 | 页面会链接到最新版本 |
登录,再用 hf 命令行下载
访问令牌是一把钥匙,让脚本以你的账号身份办事。公开模型不用令牌也能下载,受限模型则会拒绝没带令牌的请求。未登录的请求还会拿到最低的速率限制,也就是 Hub 在每个 5 分钟窗口里接受你多少次请求,未登录时按 IP 地址计算。超过限制,Hub 会返回 429 错误,这是网络上表示“请求太多”的状态码。从 1.2.0 版起,这个库遇到这种错误会自己重试。
下载大文件之前先预览。文档对 GPT-2 仓库跑了一次 --dry-run:仓库里有 26 个文件,其中 11 个还没下载,合计 5.6G。这些文件大多是同一个模型为其他运行环境另存的副本,比如 pytorch_model.bin、tf_model.h5、flax_model.msgpack,以及 ONNX 和 TFLite 文件。Transformers 优先加载 safetensors 文件,这种权重格式加载时不会执行任何代码,其余副本只会白占硬盘。
Python 里也是这两招。hf_hub_download 下载单个文件,snapshot_download 下载整个仓库,或者只下载符合你给的模式的文件。两者都返回一个指向缓存的路径。加上 --local-dir,你会在指定的文件夹里拿到真正的文件,外加一个小小的 .cache/huggingface/ 文件夹,记录每个文件的来历。想把下载固定在某个版本,就在命令行用 --revision,在 Python 里用 revision=,填一个标签、分支或提交哈希。之后作者再推送新内容,你的文件也不会变。
pip install -U "huggingface_hub"
hf auth login
hf auth whoami
hf download openai-community/gpt2 --dry-run
hf download gpt2 config.json model.safetensors- 新建一个虚拟环境,用
pip install -U "huggingface_hub"安装这个库。命令行工具就包含在里面。 - 创建令牌。在 Hugging Face 的设置里打开 Access Tokens 标签页,点 New token,再选角色、起名字。下载用只读令牌就够了。
- 运行
hf auth login。它默认通过浏览器登录,会打印一个网址和一串短码。在服务器上,把令牌放进HF_TOKEN环境变量,再运行hf auth login --token $HF_TOKEN,这样令牌原文不会留在 shell 历史里。 - 用
hf auth whoami确认登录成功。它会打印你的用户名和所属组织。 - 用
hf download openai-community/gpt2 --dry-run预览。这一步什么都不写入,每个文件都会显示还要下载多少字节。 - 只下载你会读取的文件:
hf download gpt2 config.json model.safetensors,这是下载指南里的写法。它会在最后一行打印本地路径。短 id 能用,是因为 Hub 会把gpt2重定向到openai-community/gpt2。 - 看一下这个路径。不加
--local-dir时,文件会进入缓存,位置是~/.cache/huggingface/hub,Windows 上是C:\Users\username\.cache\huggingface\hub。设置HF_HOME可以把缓存挪到更大的硬盘上。
| 账号 | Hub API 调用 | 文件下载 | 网页浏览 |
|---|---|---|---|
| 未登录,按 IP 地址计算 | 500 | 3,000 | 100 |
| 免费账号 | 1,000 | 5,000 | 200 |
| PRO 账号 | 2,500 | 12,000 | 400 |
受限模型与令牌角色
受限模型是指作者要求你先提交申请、文件才会开放的模型。第 2 课文本生成示例用到的 Gemma 2 就是这样:它的页面要求你先阅读并同意 Google 的使用许可。
申请只能在浏览器里登录后提交。点 Agree 之后,你的 Hugging Face 用户名和邮箱会分享给作者,前提是作者选择收集这些信息,你在表单里填的内容也会一并发送。自动审批时,文件马上开放。人工审批时要等作者处理,而且作者以后可以随时取消你的访问权限,不会提前通知。
脚本要用登录那一步的令牌,因为浏览器里的登录状态不会带到 Python 里。在代码里,huggingface_hub 的 login() 会像命令行一样把令牌存好,下载函数也都接受一个 token 参数。在服务器上,设置好 HF_TOKEN 就够了,每次调用都会自动读取它。
每个令牌都有一个角色,规定它能做哪些事。按脚本要做的事选择角色。每台机器、每个应用各建一个令牌,作废其中一个时,其余照常工作。令牌泄露了,就在同一个 Access Tokens 标签页里删除或刷新它。
分享模型需要写入令牌。要发布你自己的模型文件夹,入门页面只用一条命令:hf upload your-username/your-model-name ./my-model-directory,大文件由命令行工具自己处理。只改一点小东西的话,仓库网页上有 Files,再点 Add file 就行。
| 角色 | 能做什么 | 适合用来 |
|---|---|---|
| Read | 读取你有权读取的所有仓库,公开或私有都行 | 下载和推理调用 |
| Write | 只读角色能做的都能做,另外可以推送到你有写权限的仓库 | 上传模型或编辑模型卡 |
| Fine-grained | 只能访问创建时勾选的资源和操作 | 生产环境的应用,比如只读取某一个受限模型 |
huggingface_hub 的维护者怎样应对速率限制和缓存
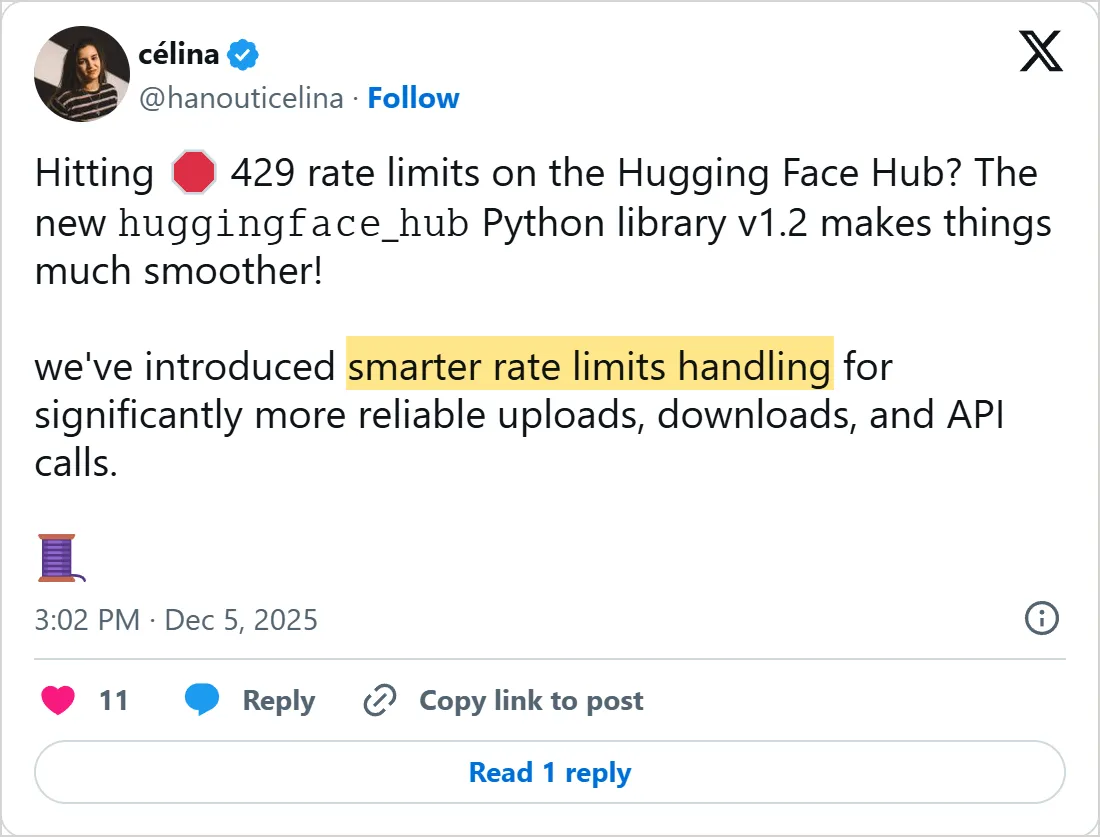
下载脚本最先撞上的,往往是速率限制。Célina Hanouti 是 Hugging Face 的工程师,也是 huggingface_hub 的共同维护者。她在 2025 年 12 月 5 日在 X 上发布了 1.2 版,这一版更聪明地处理速率限制,上传、下载和 API 调用都更稳。如果脚本还是因此停下,先运行 pip show huggingface_hub 看看版本号,再决定要不要自己写重试代码。
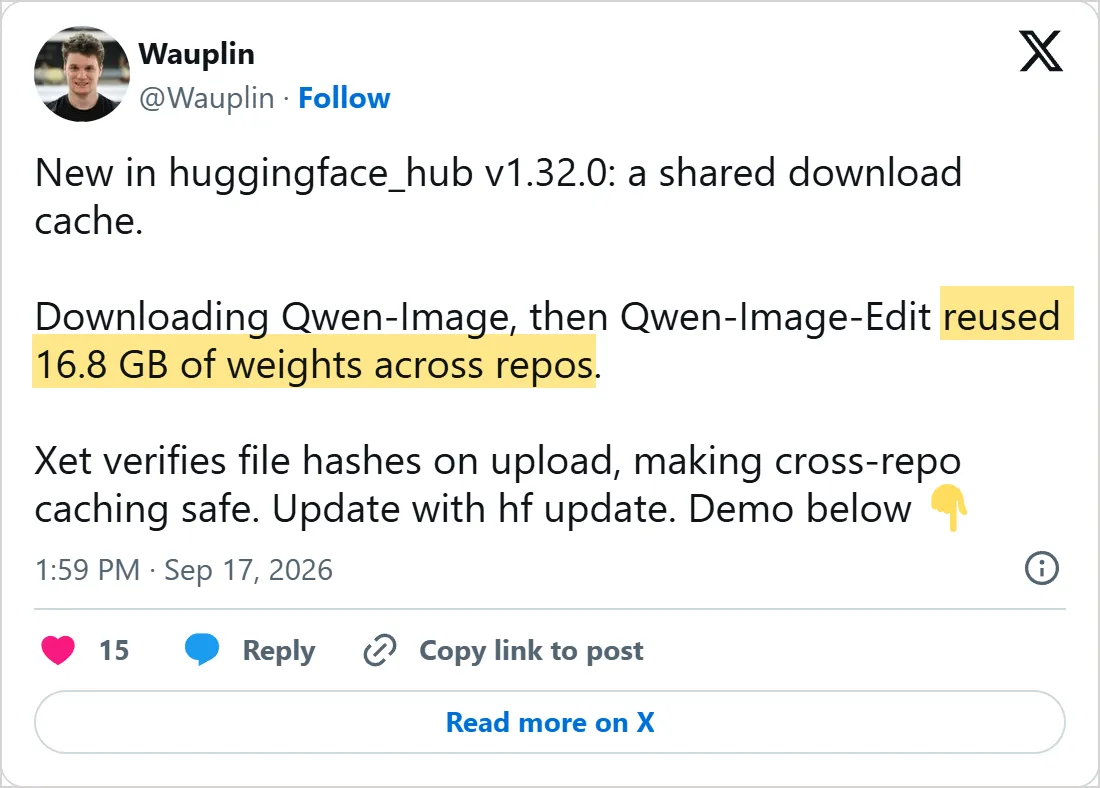
2026 年 9 月,缓存也变了。这个库的维护者 Lucain Pouget 在 9 月 17 日在 X 上介绍了 1.32.0 版:下载过的文件可以在不同仓库之间共用。他举的例子是先下载 Qwen-Image,再下载 Qwen-Image-Edit,后者复用了 16.8 GB 的权重。文件上传时就校验了哈希值,所以同一份文件可以同时供两个模型使用。他给的升级命令是 hf update。
文件可以共用之后,更要用命令行来清理缓存,别手动删。命令行指南写明,hf cache prune 还会删除已经没有任何仓库引用的共享文件。
Xet 在上传时校验文件哈希,所以跨仓库缓存是安全的。
X 官方嵌入卡片的截图,拍摄于 2026 年 11 月 5 日,时间为 UTC。点击截图可到 X 上打开原帖。
常见错误
- 照抄老教程里的
huggingface-cli命令。v1.0 已经移除了这个名字,所以要逐条换掉:huggingface-cli login现在是hf auth login。 - 习惯性地下载整个仓库。一个仓库可能把同一份权重存成五六种格式,而你的代码只读其中一种。
- 把产品押在一个受限模型上,却没有备选。批不批由作者决定,批了也能收回,所以挑模型时顺手记下一个开放的替代品。
- 旁边明明有 safetensors 副本,却去加载
.bin权重。这类文件用的是 pickle,Transformers 文档说这种 Python 格式不安全。 - 直接用
hf download下载数据集。不加--repo-type dataset时,这个命令默认找的是模型;下载演示应用要加--repo-type space。 - 把令牌原文直接写进命令里。它会留在 shell 历史中,所以命令行文档用环境变量来传令牌。
- 不登录就跑下载脚本。速率限制文档说,没有传
HF_TOKEN是大家遇到 429 错误最常见的原因。 - 直接修改下载函数返回的路径里的文件。那个路径指向缓存,改动文件会损坏缓存。先复制出来,或者下载时加
--local-dir。 - 以为
hf auth logout能让服务器退出登录。只要HF_TOKEN还在,命令行就会一直用它,直到你取消这个环境变量。
自己试一试
下面两行是下载指南里的过滤示例。GPT-2 是公开模型,不需要令牌。第一个模式保留所有 JSON 和 Markdown 文件,第二个模式仍然跳过分词器的词表文件,这样你能在同一个仓库上看到两种过滤一起起作用。
from huggingface_hub import snapshot_download
snapshot_download(repo_id="gpt2", allow_patterns=["*.md", "*.json"], ignore_patterns="vocab.json")- 把这两行粘贴进 Python 交互环境,它会显示调用返回的路径,再列出那个文件夹。预览里的哪些文件没有下载,各是被哪个模式挡掉的?
- 在终端里设置
HF_HUB_OFFLINE=1,再运行一次。断了网,它还会返回路径吗? - 运行
hf download openai-community/gpt2 --include "*.json" --dry-run,数一数仓库里有多少个 JSON 文件。 - 在模型页面找一个模型卡写着
license: other的模型,打开它的许可证链接。收费应用能用它吗? - 运行
hf cache ls,在列表里找到 GPT-2。再用 CLI 指南自己的示例hf cache rm model/gpt2删掉它,然后再列一次缓存。还剩下什么?
接下来
文件躺在硬盘上还什么都做不了。第 2 课用一次 pipeline() 调用加载模型,并讲解决定它能不能跑起来的设备和内存设置。那一课的文本生成示例用的是受限的 Gemma 2,现在就去申请,等你学到那里,批准可能已经下来了。你的电脑跑不动的大模型放在第 3 课,由托管提供商替你运行。挑大模型之前,本地大模型硬件那一课讲了每种规模的模型需要多少内存。
自测一下
用现在的 Hugging Face 命令行,哪条命令负责登录?
查看答案
C. hf auth login 工具已改名为 hf,登录移到了 hf auth 下面,v1.0 也移除了 huggingface-cli 这个名字。
给 hf download 加上 --dry-run 会怎样?
查看答案
A. 列出每个文件和还要下载的字节数,不写入任何东西 预览会显示这次下载会新增什么,你就能去掉那些永远不会加载的格式。
模型卡写着 license: other,使用之前该做什么?
查看答案
D. 阅读 license_name 指明、license_link 链接的条款 other 表示自定义条款,只有这些条款能说明你的用法是否被允许。
不加 --local-dir 时,hf download 把文件放在哪里?
查看答案
B. 缓存里,默认在 ~/.cache/huggingface/hub 不传 --local-dir 时文件都进缓存,设置 HF_HOME 可以移动缓存位置。
常见问题
Hugging Face 免费吗?
基础功能免费:注册账号、浏览和下载公开模型都不花钱。PRO 套餐会提高你的速率限制,并附带每月可用于托管模型的额度。免费账号没有每月额度,但可以自己购买。第 4 课会讲到托管演示应用在哪些情况下需要付费套餐。
怎样删除下载过的模型,腾出硬盘空间?
用缓存命令。hf cache ls 列出已存的内容,hf cache rm 删除你指定的仓库或版本,hf cache prune 删除没有任何引用的旧版本。两个删除命令都可以加 --dry-run 先预览。
我有权限的受限模型,整个团队都能用吗?
不能。访问权限是按个人用户授予的,所以每位同事都要自己申请。如果是生产环境的应用,令牌文档建议由一位有权限的成员创建一个细粒度令牌,只读取那一个模型。
能不能直接用 git clone 下载模型?
可以,每个模型都是一个 git 仓库,但大文件需要先安装 Git Xet 扩展(git xet install)。hf 工具不用额外设置就能处理大文件,还能只挑几个文件下载,clone 做不到这一点。
资料来源
- Hugging Face Hub documentation https://huggingface.co/docs/hub/index
- Hugging Face Hub: Model cards https://huggingface.co/docs/hub/model-cards
- Hugging Face Hub: Licenses https://huggingface.co/docs/hub/repositories-licenses
- Hugging Face Hub: Gated models https://huggingface.co/docs/hub/models-gated
- Hugging Face Hub: User access tokens https://huggingface.co/docs/hub/security-tokens
- Hugging Face Hub: Rate limits https://huggingface.co/docs/hub/rate-limits
- Hugging Face Hub: Getting started with repositories https://huggingface.co/docs/hub/repositories-getting-started
- huggingface_hub: Installation https://huggingface.co/docs/huggingface_hub/installation
- huggingface_hub: Command Line Interface (CLI) https://huggingface.co/docs/huggingface_hub/guides/cli
- Hugging Face: Download files from the Hub https://huggingface.co/docs/huggingface_hub/guides/download
- huggingface_hub: Migrating to v1.0 https://huggingface.co/docs/huggingface_hub/concepts/migration
- Hugging Face blog: Say hello to hf https://huggingface.co/blog/hf-cli
- Transformers: Installation https://huggingface.co/docs/transformers/installation
- Transformers: Loading models https://huggingface.co/docs/transformers/models
- Inference Providers: Pricing and billing https://huggingface.co/docs/inference-providers/pricing
- Hugging Face: google/gemma-2-2b model page https://huggingface.co/google/gemma-2-2b
- Célina Hanouti on X: huggingface_hub v1.2 and 429 rate limits https://x.com/hanouticelina/status/1996958360323735611
- Lucain Pouget on X: a shared download cache in huggingface_hub v1.32.0 https://x.com/Wauplin/status/2100585417875603856