
开始之前
你需要 Python 3.10 或更新版本、anthropic 包(pip install anthropic),以及放在 ANTHROPIC_API_KEY 里的 API 密钥。
下面的代码来自 Anthropic 的 Building Evals cookbook。它的提交记录显示,这份 notebook 最近一次修改是在 2026 年 10 月 24 日,模型从那时起换成了 claude-opus-5-5。评估逻辑本身是普通的 Python,换成别家服务商的 SDK 也一样能用。如果你还没调用过 API,Claude API 课程的快速上手一课会带你拿到第一条回复。
跑一个三行的评估
这是值得一跑的最小评估。任务是问模型某种动物有几条腿,只要一个数字,所以用字符串比较就能打分。前两行很简单。第三行说一只狐狸丢了一条腿,又长了回来,还额外多长了一条。它的标准答案是 5,检查的是模型照着眼前这句话回答,还是照着它对狐狸的常识回答。
标准答案(golden answer)就是一条完美回复应当给出的输出。运行脚本后,先把打印出来的输出和各自的标准答案对照着读一遍,再去看最后那行分数。
from anthropic import Anthropic

client = Anthropic()
MODEL_NAME = "claude-opus-5-5"


# Define our input prompt template for the task.
def build_input_prompt(animal_statement):
    user_content = f"""You will be provided a statement about an animal and your job is to determine how many legs that animal has.

    Here is the animal statement.
    <animal_statement>{animal_statement}</animal_statement>

    How many legs does the animal have? Return just the number of legs as an integer and nothing else."""

    messages = [{"role": "user", "content": user_content}]
    return messages


# Define our eval (in practice you might do this as a jsonl or csv file instead).
eval = [
    {"animal_statement": "The animal is a human.", "golden_answer": "2"},
    {"animal_statement": "The animal is a snake.", "golden_answer": "0"},
    {
        "animal_statement": "The fox lost a leg, but then magically grew back the leg he lost and a mysterious extra leg on top of that.",
        "golden_answer": "5",
    },
]


# Get completions for each input.
# Define our get_completion function. The answer is a single integer, so we ask for low effort;
# max_tokens leaves headroom because any thinking the model does counts toward it.
def get_completion(messages):
    response = client.messages.create(
        model=MODEL_NAME,
        max_tokens=1024,
        output_config={"effort": "low"},
        messages=messages,
    )
    # The response can start with a thinking block, so read the text block rather than content[0].
    return next((block.text for block in response.content if block.type == "text"), "").strip()


# Get completions for each question in the eval.
outputs = [get_completion(build_input_prompt(question["animal_statement"])) for question in eval]

# Let's take a quick look at our outputs
for output, question in zip(outputs, eval, strict=False):
    print(
        f"Animal Statement: {question['animal_statement']}\nGolden Answer: {question['golden_answer']}\nOutput: {output}\n"
    )


# Check our completions against the golden answers.
# Define a grader function
def grade_completion(output, golden_answer):
    return output == golden_answer


# Run the grader function on our outputs and print the score.
grades = [
    grade_completion(output, question["golden_answer"])
    for output, question in zip(outputs, eval, strict=False)
]
print(f"Score: {sum(grades) / len(grades) * 100}%")- 把提示词写成模板,给会变的输入留一个位置,这里是
animal_statement。 - 列出各行,每行是一个输入和它的标准答案。用 JSONL 或 CSV 文件存也可以。
- 让每一行都跑一遍模型,保存原始输出。
- 把每个输出和它的标准答案比对,打印通过的比例。
- 只改一处,比如提示词里的一句话或者模型名,再把所有行重跑一遍,比较前后两个分数。
代码取自 GitHub 上 Anthropic 的 Building Evals cookbook。原文提示词里两次把“statement”拼成了“statment”,其中一次在闭合标签里,我们把两处都改正了,好让标签前后一致。
分数能说明什么,又会掩盖什么
这份 cookbook 把一个评估分成四部分:输入的提示词、模型给出的输出、标准答案和分数。测试行和标准答案你只需写一次,打分却是每跑一次就付一次成本,而你每改一次提示词、每换一次模型都会重跑。所以 cookbook 把便宜又快速的打分放在设计的中心。
精确匹配很严格。如果模型对“人”那一行回答“Two”或“2 legs”,评分代码就会把正确答案判成错。Anthropic 在代码评分的弱点里把它列在第一条:遇到不完全符合预期写法的有效变体,就会失灵。提示词最后那句“Return just the number of legs as an integer and nothing else”,正是字符串比较在这里算得上公平的原因。去掉它,你就得换成更宽松的检查,或者让模型来打分。
只有三行时,每一行都会让分数变动三分之一。模型每次运行的输出会有差异,所以 Anthropic 把每次尝试叫作一次试验(trial),并且对每个任务跑多次试验,让数字更稳定。在相信百分比的变化之前,先读一读没通过的那几行。
先读运行记录,再写测试
“腿”那几行是编出来的。你的应用的测试行应当来自它自己的失败,而这些失败要靠读运行记录来找。运行记录(trace,Anthropic 也叫 transcript)是一次运行的完整记录:输入、每一次模型调用和工具调用、中间结果,以及最终输出。错误分析就是读一批运行记录,把每条里出了什么错写下来。
OpenAI 的评估飞轮 cookbook 把这件事分成两遍。第一遍是开放编码:读没通过的运行记录,用你自己的话给每个错误贴一个简短标签,这时还不需要固定的分类表。它的例子是一个公寓租赁助手,其中一个标签写的是“bot suggested a tour time that wasn't available”,也就是助手推荐了一个已经约不上的看房时间。第二遍是轴向编码:把这些标签归成几类,比如“Tour scheduling/rescheduling issue”(看房预约和改约问题)和“Formatting error with output”(输出格式错误)。数一数每一类有多少条运行记录,最大的那一类就是你的第一个测试。
挑样本时要追求多样,而不是看哪个问题最常见。Hamel Husain 和 Shreya Shankar 发布的 error-discovery 技能,第一批审阅样本大部分取自各个聚类的代表,另有大约 30% 到 40% 是随机抽的,用来补上聚类漏掉的部分。
20-50
个取自真实失败的简单任务:Anthropic 建议的智能体评估起点
来源:Anthropic: Demystifying evals for AI agents (2026年11月6日 查阅)
~50
条没通过的运行记录,先做开放编码贴标签,再归类
来源:OpenAI Cookbook: Building resilient prompts using an evaluation flywheel (2026年11月6日 查阅)
把失败变成测试行
Anthropic 的建议是,从你每次发布前已经在手动做的检查,以及用户最常做的任务开始。如果应用已经上线,缺陷跟踪系统和客服工单里就有现成的行可以照抄。年轻的应用每改一处,效果往往都很明显,所以一个小集合就足以看出差别。文章还说,评估拖得越久越难建,因为到后来,你得从一个正在运行的系统里倒推“成功”原本是什么意思。
每一行都要写到两位领域专家各自判断时,会给出相同的通过或不通过结论。他们会争论的行只会给分数添噪声,而不是信号。能做到的话,再附一个参考解,也就是一个能通过所有检查的输出,证明这一行确实有可能通过。
然后测另一个方向。Anthropic 为 Claude.ai 的网页搜索做评估时,既放了模型应该去搜的问题(比如天气),也放了它应该凭已有知识直接回答的问题(比如“who founded Apple?”,苹果是谁创立的)。只检查某个行为有没有发生的测试集,会奖励一个处处都触发这个行为的提示词。OpenAI 还会在里面加入边界情况:错别字、只有一个词的请求(比如“returns”)、一条消息里问好几个问题,或者用户提示词和系统提示词互相冲突。
| 测试行从哪里来 | 一行示例 |
|---|---|
| 每次发布前手动做的检查 | 订单状态的回复里带有物流单号 |
| 一条缺陷报告或客服工单 | 那位被推荐了已约满看房时间的用户 |
| 运行记录审阅里最大的那一类 | 另外五条以同样方式失败、来自不同用户的运行记录 |
| 反方向的情况 | 一个应用不调用工具就该回答的问题 |
| 边界情况 | 只有一个词的消息“returns” |
选代码评分还是模型评分
评分器(grader)是给输出打分的逻辑。Anthropic 的建议是:能用确定性评分器就用,必要时才用模型评分器,人工评分少用,主要拿来检验另外两种。代码又快又便宜,每次运行结果都一样,但遇到没预料到的有效写法就会出错。模型评分器能处理细微差别和自由文本,却不确定,每跑一次更贵,而且要先和人工判断对照过才能信任。
write-code-eval 技能把每一类失败当成一个单元测试,为它配一项检查。有些看起来很主观的失败,其实也能用代码判断。同一个仓库里的评委技能举了个例子:一个面试辅导助手本该问某次具体的过往经历,却去问平时一般怎么做。对这种情况,技能认为用关键词检查查找“usually”“typical”“normally”这几个词,可能就相当管用。这只是普通的字符串匹配。语气、是否忠于文档、回答是否完整,这些需要解读,第 2 课会为它们写一个评委。如果是 RAG 流水线,RAG 课程的评估一课用一张表比较了代码、人工和模型三种评分方式。
| 失败类别 | 代码能做的检查 |
|---|---|
| 输出结构无效 | 解析输出,检查必填字段 |
| 缺少或出现了不该有的文字 | 匹配字符串或模式 |
| 引用了检索结果里没有的文档 | 比较引用的 ID 和检索到的 ID |
| 工具调用有问题 | 按工具的 schema 检查参数 |
| 数值错误 | 把输出和参考值比较 |
Greg Brockman 谈评估,Hamel Husain 和 Shreya Shankar 谈先读运行记录
Greg Brockman 的 X 简介写着他是 OpenAI 的总裁和联合创始人。2023 年 12 月 9 日,他在 X 上只发了一句话:评估常常出人意料地就是你所需要的全部。OpenAI 的 evals 仓库至今仍把这条帖子放在 README 靠前的位置。在你换更大的模型或者动手微调之前,几行像“腿”评估那样的测试就能告诉你,接下来这次改动到底有没有用。
Hamel Husain 和 Shreya Shankar 一起教一门 AI 评估课,他们把自己的方法做成了 GitHub 上的智能体技能。README 说其中最重要的是错误发现(error discovery)。让你的编程智能体去读一个运行记录文件,比如 traces.jsonl,这个技能会搭一个审阅应用,挑出一批多样的样本,再把你随手写的备注归成几类失败模式。上面讲的开放编码,就是手工做同一件事。
下面的视频来自 Hamel Husain 的频道。课程的 recipe-chatbot 仓库把它列为错误分析作业的开放编码和轴向编码讲解。
只有做完这一步之后,你才应该去写评估。
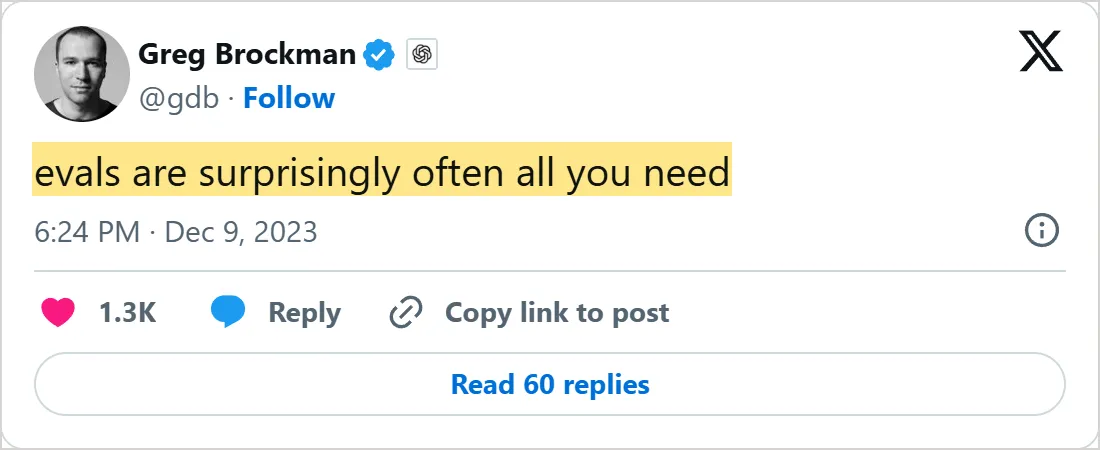

X 官方嵌入卡片的截图,拍摄于 2026-11-06,时间为 UTC。点击截图可到 X 上打开原帖。
常见错误
- 一条运行记录都没读,就凭想象写测试行。结果测的是你猜的问题,而不是真正出错的地方。
- 用精确匹配给自由文本打分。“Two”和“2”对不上,所以要么要求固定格式,要么换一种更宽松的检查。
- 保留两位专家会给出不同判定的行。他们的分歧会变成每个分数里的噪声。
- 只测某个行为有没有发生。没有“不该发生”的行,一个过分积极的提示词照样每行都能通过。
- 一上来就用模型评分。关键词检查或 schema 检查更便宜,而且每次运行给出的结果都一样。
- 随手看几条回复就当成做了评估。OpenAI 把“看起来能用”列为反模式之一。
自己试一试
- 跑一遍“腿”的三行,再自己加第四行,写一句动物描述和它的标准答案。
- 删掉提示词最后那句只要数字的要求,再跑一遍。对每个没通过的行,判断出错的是模型还是评分代码。
- 从你自己的应用里取 30 条运行记录,每个失败写一个简短标签,再把标签归成三到五类。
- 为最大的那一类写两行:一行应当抓到这个失败,一行的行为是正确的。
- 挑一个需要判断力的类别,比如语气,亲手标出至少 20 条通过、20 条不通过的运行记录。下一课写的评委就从这些标注起步;要可靠地检验它,还得标更多,下一课会讲到。
自测一下
一个精确匹配的评分代码期望的答案是“2”,哪个正确回复会被它判为失败?
查看答案
B. “2 legs” 精确匹配比较的是整个字符串,多一个词就会让正确答案失败,所以提示词才要求只给数字。
你手上有 300 条线上运行记录,还没有任何测试,第一步做什么?
查看答案
C. 读一批运行记录,给每个失败贴标签 错误分析能找出你的应用实际有的失败模式,而这些模式决定了哪些测试值得写。
下面哪一行测试写得好?
查看答案
D. 两位领域专家会给出相同通过或不通过判定的一行 Anthropic 衡量好任务的标准,是两位专家各自判断时得出相同结论,这样歧义才不会变成噪声。
哪种失败应该用代码检查,而不是交给模型?
查看答案
A. 回复里缺少一个必填的 JSON 字段 解析输出、检查必填字段是代码能执行的规则,而语气和忠实度需要解读。
常见问题
什么是大模型评估?
它是给基于语言模型的应用做的测试:一个输入、作用在输出上的打分逻辑,以及一个你持续跟踪的分数。Anthropic 的定义也覆盖智能体,这时输入是一项任务,打分可以检查环境里实际发生了什么变化。
评估和基准测试是一回事吗?
不是。OpenAI 指出,“evals”可以指 MMLU 这样的行业基准、ROUGE 这样的标准分数,也可以指你为自己的应用写的测试。基准测试用别人的任务比较模型,你的评估检查的是你的提示词、工具和数据。
起步需要多少测试行?
比大多数团队以为的少。Anthropic 说,早期的改动效果大,小样本就能看出来,成熟的智能体才需要更大、更难的测试集来发现更小的差别。每出现一个新的失败,就加一行。
我需要评估框架吗?
不需要。本课的评估就是一个字典列表加一个循环。框架会加上缓存、报告,以及在每个拉取请求上自动运行,这些在本课程的第 4 课里配置。
还能用 OpenAI 的 Evals API 吗?
只能读取已有的内容。截至 2026 年 11 月 6 日,OpenAI 的弃用页面写着:已有的评估从 10 月 31 日起变为只读,Evals 控制台和 API 计划在 11 月 30 日关闭。页面给出的迁移方向是 promptfoo。
资料来源
- Anthropic: Demystifying evals for AI agents (9 January 2026) https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Anthropic Cookbook on GitHub: Building Evals https://github.com/anthropics/claude-cookbooks/blob/main/misc/building_evals.ipynb
- GitHub: building_evals.ipynb commit history https://github.com/anthropics/claude-cookbooks/commits/main/misc/building_evals.ipynb
- OpenAI Docs: Evaluation best practices https://developers.openai.com/api/docs/guides/evaluation-best-practices
- OpenAI Docs: Deprecations (Evals platform) https://developers.openai.com/api/docs/deprecations
- OpenAI Cookbook: Building resilient prompts using an evaluation flywheel https://developers.openai.com/cookbook/examples/evaluation/building_resilient_prompts_using_an_evaluation_flywheel
- GitHub: ai-evals-course/evals-skills README https://github.com/ai-evals-course/evals-skills
- evals-skills on GitHub: error-discovery skill https://github.com/ai-evals-course/evals-skills/blob/main/skills/error-discovery/SKILL.md
- evals-skills on GitHub: write-code-eval skill https://github.com/ai-evals-course/evals-skills/blob/main/skills/write-code-eval/SKILL.md
- evals-skills on GitHub: write-judge-prompt skill https://github.com/ai-evals-course/evals-skills/blob/main/skills/write-judge-prompt/SKILL.md
- GitHub: ai-evals-course/recipe-chatbot README https://github.com/ai-evals-course/recipe-chatbot
- GitHub: openai/evals README https://github.com/openai/evals
- Greg Brockman on X: evals are surprisingly often all you need (9 December 2023) https://x.com/gdb/status/1733553161884127435
- YouTube, Hamel Husain: Open & Axial Coding - Isaac & Hamel Walkthrough https://www.youtube.com/watch?v=AKg27L4E0M8
- PyPI: anthropic (requires Python 3.10 or later) https://pypi.org/project/anthropic/