开始之前
你只需要一个能生成图片的应用,免费账号就能起步。ChatGPT Images 在所有 ChatGPT 套餐里都能用,网页、iOS 和 Android 都支持。Gemini 应用用 Nano Banana 2 免费出图。Midjourney 是第三个选择,它有自己的一套提示词规则。这一课的写法三者通用,只有提示词长短这一点不同,Midjourney 的文档写得很清楚。
在 ChatGPT 里,可以在任意对话里直接要图,也可以选 More,再选 Images,那里的 Templates 提供海报、标志这类起点。出一张图可能要几分钟,等待时你可以继续聊天。在 Gemini 里,从工具菜单选 Create images,或者打开侧边栏,点 Images。
ChatGPT 会把你生成的每张图都存在 Images 里,之后可以重新打开、反复使用。Gemini 有 Google AI 套餐时可以下载 2K 图,没有套餐时是 1K,做幻灯片或社交媒体配图已经够用。
提示词,就是你输入的、描述想要什么图的那段文字。图像模型,是把这段文字变成像素的那个 AI。每个应用用的模型不同,所以同一条提示词,在不同应用里会得到不同的图。模型每隔几个月还会换代。Gemini 的概览页现在列出,有 Google AI 套餐就能用 Nano Banana 2.1,Google 称它是自家最好的图像生成和编辑模型。
挑一张你这周真要用的图,而不是随便找个题目练手。活动海报、商品图、幻灯片插图都可以。真实的用途给了你判断结果的标准:要么能用,要么不能用。
Nano Banana
Google 发布 Gemini 2.5 Flash Image 预览版,这是它的原生图像生成模型。
来源:Google AI Studio 更新日志 (2026年11月5日 查阅)
分五步写出第一条提示词
每一步加上一个部分。下面这个示例是我们自己写的,参照了 Google 图像生成文档里的写实照片模板。把主体换成你的就行。
先通读一遍再看步骤。它先写主体和用途,再写地点,最后写光线和镜头,就像向一位从没见过你家面包店的摄影师交代任务。
一张写实风格的特写照片:一个圆形酸面包放在撒了面粉的木桌上,
背景是一间小面包店的厨房,用作面包店周末菜单的封面。
清晨的窗光从左边照进来,阴影柔和,色调偏暖。
低机位拍摄,50mm 镜头。方形画面。- 说明这张图的用途。“周末菜单的封面”比“一张面包照片”给模型的信息多得多。Google 用标志举过同样的例子:说明是给一个高端极简护肤品牌做的标志,效果好过只说“做一个标志”。用途也决定了画幅,以及版面需要留出的空白。
- 写清主体和它的动作。挑最准确的词:“巨大”比“大”说得更清楚。用具体数字代替复数,写“三只猫”,不写“一些猫”,也可以用“一群鸟”这样的集合词。画面里有人,还要写姿势:露出多少身体,视线看向哪里,手在做什么。比如“低头看着摊开的书”“双手自然地握着车把”。
- 给它一个地点。室内还是室外,哪个房间、哪条街,一天中的什么时候。场景同时也告诉模型,光从哪里来。“放在抛光水泥台面上”的杯子,“趴在洒满阳光的窗台上”的猫,读起来就已经是一个场景了。
- 选定风格或媒介。写实照片、炭笔画、水彩画、卡通插画,都是 Gemini 帮助页面里举的例子。想要看起来像照片的效果,就直接写“写实”或“真实照片”这几个字。
- 定下构图和光线。写出景别(特写、广角、微距)、机位角度(低机位、平视)和光线(柔和的窗光、影棚灯光)。镜头术语只是对画面效果的提示,并不保证画面和真实镜头拍出来的一样,所以“50mm 镜头”只能让画面往那个方向靠。画幅也在这一步定下来:海报和手机屏幕用竖版,幻灯片用横版。
顺序是习惯,不是规则。按 OpenAI 的说法,短提示词、段落、清单和标签都能表达同样的意图,用你自己最容易读、最容易改的写法就好。
改变画面的那些词
在提示词长短上,几个应用的说法不一样。Google 的最佳做法要求写细:细节给得越多,你能控制的就越多。Midjourney 恰恰相反,见下面的引文,它还说长长的清单和细致的指令反而会把它弄糊涂。在 Midjourney 里,细节少,变化就多,控制就少。
所以,给 ChatGPT 和 Gemini 写完整的描述。到了 Midjourney,就删到只剩主体、媒介和一两个风格词,像它自己的例子“彩色铅笔插画,鲜橙色的加州罂粟花”那样。
只靠情绪词,力道不够。拍宽阔的、下雨的、昏暗的或霓虹灯下的场景,OpenAI 的指南要求写出尺度、氛围和色彩,而不是只写“有氛围感”或“电影感”。材质也要写出来:磨旧的皮革、湿漉漉的柏油路、拉丝不锈钢。
不知道还能加什么?Midjourney 列的七个方面正好当检查清单:主体、媒介、环境、光线、色彩、情绪和构图。
Google 的文档还给常见任务准备了填空模板,这些结构在任何应用里都能用:
下表收集了几份指南里举例用的词,每类配一个小示例。一次只换一行,把几张图并排比较。
为什么 Midjourney 的提示词要短
在 Midjourney 里,简短的提示词通常能生成最好的图。
- 贴纸和图标:先写风格、主体和它的配饰,再写视觉细节,比如干净的粗轮廓、简单的赛璐璐上色、白色背景。
- 商品图:一张高清、影棚布光的商品照片,放在写明的台面上,再写清布光方式、机位角度,以及必须清晰对焦的那个细节。
- 给标题做背景:一个小小的主体放在角落,其余是大片空白的画布,给你之后加的文字留出位置。
- 漫画:写“做一组 3 格漫画”,并指定画风,每一格里都是同样的角色。
| 你要控制的 | 指南里的词 | 写进提示词的示例 |
|---|---|---|
| 媒介 | 照片、油画、插画、雕塑、涂鸦 | 一幅炭笔画的灯塔 |
| 景别和角度 | 广角、微距、低机位、特写、鸟瞰 | 微距拍摄蜘蛛网上的露珠 |
| 光线 | 柔光、环境光、阴天、霓虹、影棚灯光 | 阴天的光洒在安静的港口上 |
| 色彩 | 鲜艳、低饱和、单色、粉彩、黑白 | 低饱和的粉彩色调 |
| 情绪 | 俏皮、平静、阴郁、充满活力 | 黎明时分平静空旷的海滩 |
| 画幅 | 方形、横版、竖版,或 16:9 这样的比例 | 最后一行写“画面比例 16:9” |
让图里出现文字
文字是公认的薄弱环节。OpenAI 的图像生成指南把“精确的文字位置和清晰度”列为自家模型的局限,所以每个字都要准备核对。下面的海报提示词是我们写的,遵循了列表里的规则。
Gemini 有自己的窍门。图片里需要文字的时候,Google 建议先把文字生成出来,再让它用这些文字做图。先在对话里把标题和小字定稿,然后再要海报。
文字用哪种语言,也有讲究。Gemini 的帮助页面说,它在所有支持的语言里拼写都更准确,而 Midjourney 处理拉丁字母效果最好。要做一块中文或日文招牌,就从 Gemini 开始。
按原尺寸检查文字,不要只看对话里的缩略图。有一个字错了,追问一句,给出正确的写法,并要求其他部分保持不变。
一张社区换书活动的海报,扁平插画风格,
树下的公园长椅上放着几摞彩色的书。
顶部写着“周日换书会”,字体是粗体圆角无衬线字。
底部用小一点的字写:“6月14日 榆树公园 上午10点”。
不要其他文字。竖版画面。- 把要出现的字原样放进引号。在 Midjourney 第 6 版及以后的版本里,放在双引号中的词会出现在图上。单引号和撇号不起这个作用。
- 说明文字放在哪、长什么样。“顶部,粗体圆角无衬线字”就够了。用平常的话描述字体的样式。
- 只要这一处文字,别的都不要。“标语只出现一次”和“不要多余文字,不要水印,不要无关的标志”,都出自 OpenAI 自己的广告示例。
- 生僻的名字一直写错,就逐个字母拼出来。
- 文字尽量短。Midjourney 处理标准拉丁字母的短词短语效果最好,它还建议在提示词里加上“写着”或“with the words”这类提示。
Gemini 团队和 Max Woolf 在 Nano Banana 提示词里写什么
Gemini 应用的官方账号在 2026 年 4 月 13 日 在 X 上发过一份提示词清单,分成六项:主体、构图、动作、地点、风格,以及改已有图片时的编辑指令。构图指的是画面怎样取景。改图时,它要求直接、具体,比如“去掉背景里的那辆车”。前五项和这一课的步骤一一对得上,它唯一没提的是图片的用途。
Max Woolf 曾是 BuzzFeed 的高级数据科学家。2025 年 11 月,他 在博客上详细测试了第一代 Nano Banana,笔记本放在 GitHub 上。
他发现,把 MUST 写成大写,模型会更严格地遵守那条规则。加一句不要文字和水印,能去掉多余的字,画面保持不变。一条请求里提五处修改,开头写“Make ALL of the following edits to the image”,在他的测试里五处都改对了。
最后这一点,和“一次只改一处”的习惯并不冲突:前提是你已经知道要改哪些地方。还在摸索的时候,一次改一处,才看得出是哪个词起了作用。Woolf 测的是比现在的 Nano Banana 2 更早的模型,每个技巧都先在你自己的应用里试一试。下面的视频带你走一遍 Google 官方的图像指南,附有实例。
想让 Nano Banana 生成的图发挥到最好,就先把故事、主体和风格交代清楚。
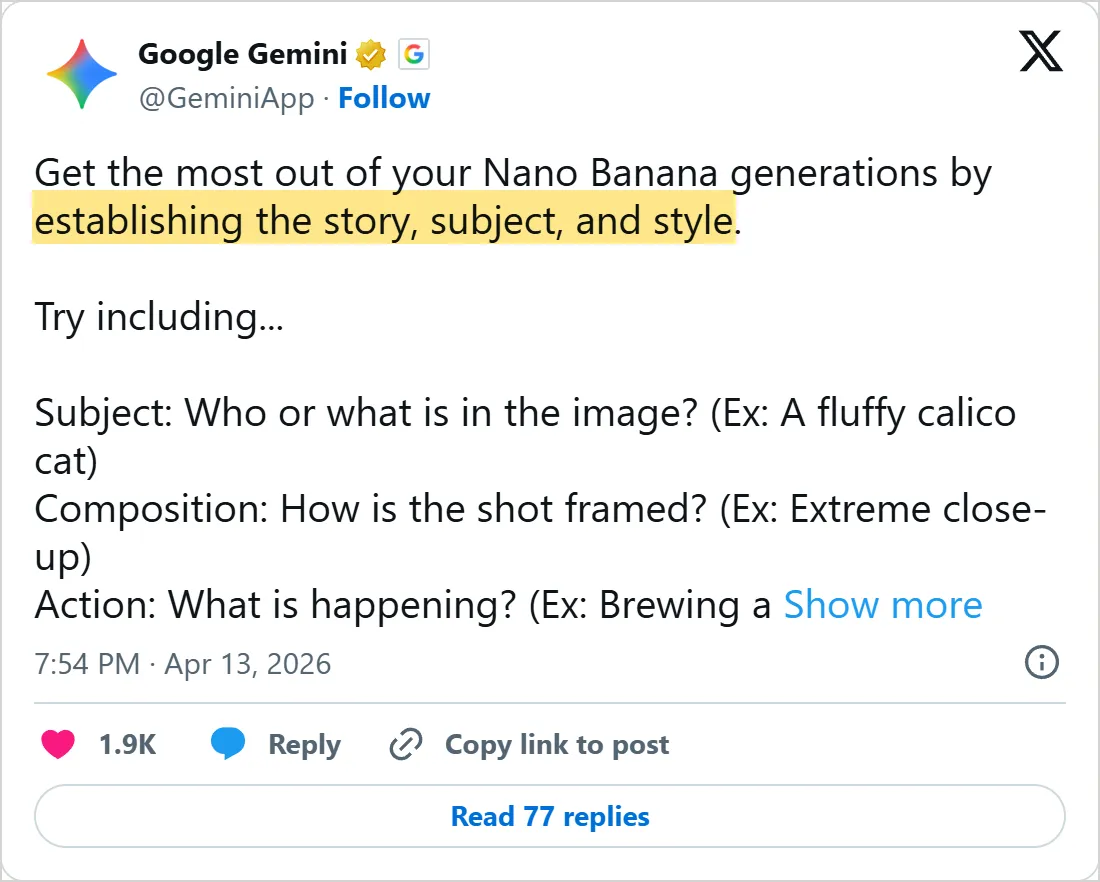

X 官方嵌入卡片的截图,拍摄于 2026-11-05,时间为协调世界时(UTC)。X 用“Show more”截断了帖子后面的内容。点击截图可到 X 上打开原帖。
常见错误
- 写你不想要的东西。“一个没有蛋糕的派对”照样可能在桌上画出蛋糕。Google 给的改法是:不写“不要汽车”,而写“一条空荡荡、看不到任何车流的街道”。
- 一次追问改五处。新图更差的时候,你分不清是哪一处改坏的。改一处,看一眼,再改下一处。
- 画幅留到最后再定。从方形图里裁出一张竖版海报,上下两头都会被切掉,所以第一条提示词就写好画面比例,或者用 ChatGPT 的画面比例选择器。
- 每次没画对就开一个新对话。追问一句“其他都不变,把光线调暖一点”,能把已经对的部分留住。
- 相信它的拼写。发出去之前,放大检查图上的每一个字,连小字也不要漏掉。
- 指望它给出准确的张数。Gemini 不一定按你要求的数量出图,打算用四个版本之前,先数一数。
- 不写用途。没有“做菜单封面”或“做幻灯片背景”这样的交代,模型就没有理由给标题留出位置。
自己试一试
就用开头选好的那张图。每个练习只改一样东西,这样你能看清这一样东西起了什么作用。
把每条提示词和它生成的图放在一起记下来。跑上五次,你就有了一张小抄:哪些词在你用的应用里管用,哪些词它根本不理。
- 按五个部分为你的真实需求写好提示词,运行一次。
- 只改光线,再运行一次,把两张结果并排放好。
- 加一行放在引号里的文字,逐字对照你输入的内容。
- 把同一条提示词贴进另一个应用,记下它忽略了哪些部分。
- 要一个在一侧留出空白、方便放标题的版本,看看主体会不会挪位置。
一张图算不算完成,看这几点:用途一眼能看出来,引号里的每个字都没写错,放到原尺寸时手和脸经得起看,标题要放的地方留出了空间。
下一课:用 AI 修图
从文字生成新图,只是一半的工作。很多时候你手里已经有照片,只想改其中一样:天空、沙发或者背景。下一课用 AI 修图讲的就是这件事,分别用 Gemini 里的 Nano Banana 和 ChatGPT 来做,那里的提示词会用上你在这一课练过的写法。第 3 课讲视频,第 4 课用 ComfyUI 在你自己的电脑上运行图像模型。
交代背景、给出示例、一次只改一处,这些习惯在文字提示词里同样适用,提示词工程入门那一课讲的是聊天回复,而不是图片。
自测一下
你需要一张做面包店菜单封面的照片,哪条提示词给模型的信息最多?
查看答案
C. 写实风格的特写:撒了面粉的桌上放着一个酸面包,清晨窗光,用作菜单封面 它写出了用途、主体、场景、风格和光线,正是这一课搭起来的五个部分。
怎样让“Book Swap Sunday”这几个词出现在 Midjourney 生成的海报上?
查看答案
A. 放进双引号 从第 6 版起,Midjourney 会把双引号里的词画进图里,单引号不起作用。
你想要一条没有汽车的街道,哪种写法符合 Google 的建议?
查看答案
B. 一条空荡荡、看不到任何车流的街道 Google 让你描述想要的画面,而不是列出要去掉的东西。
你同时改了风格、光线和角度,新图反而更差了,下一步该怎么做?
查看答案
D. 退回去,三处里只改一处 每次只改一处,你才看得出是哪一处带来了变化。
常见问题
ChatGPT 或 Gemini 能帮我写图像提示词吗?
能,Google 在 Flow 的帮助页面里就这样建议:把你的提示词、一张图甚至一段视频发给 Gemini,请它写出新的提示词。可以让它写两三个版本,彼此只差一处,比如光线。运行之前,把你从没要求过的细节删掉。
为什么 AI 生成的图里文字总是拼错?
又小又要求精确的文字,对图像模型来说仍然很难。有两个设置可能有用。OpenAI 的提示词指南建议,遇到小字或信息密集的画面,比较一下 medium 和 high 两档质量;在 Gemini 应用里,付费用户可以选 Redo with Pro,Google 说它能为带文字的图片补上更多细节。
在 ChatGPT 和 Gemini 里能用负面提示词吗?
能,写成提示词里的普通句子就行。先描述你想要的画面,再简短地排除多余文字、标志或水印这类东西,OpenAI 的示例就是这么写的。在 Midjourney 里,排除项有一个专门的参数,叫 no。第 4 课讲的 ComfyUI,则给负面提示词单独设了一个输入框。
Midjourney 的提示词能直接用在 ChatGPT 里吗?
照搬往往不行。Midjourney 会在提示词末尾加上叫作参数的设置,ChatGPT 和 Gemini 读的则是平常的句子。把它改写成平常的句子,或者从 Google 概览页上的公式开始:生成一张图,写清主体、动作和场景。
资料来源
- Google: Nano Banana image generation (Gemini API docs) https://aistudio.google.com/docs/image-generation
- Google: Generate & edit images with Gemini Apps https://support.google.com/gemini/answer/14286560?hl=en
- Google: Gemini image generation overview https://gemini.google/overview/image-generation/
- OpenAI: Image prompting guide https://developers.openai.com/api/docs/guides/image-prompting
- OpenAI: Image generation guide https://developers.openai.com/api/docs/guides/image-generation
- OpenAI Help Center: Images in ChatGPT https://help.openai.com/en/articles/11084440-images-in-chatgpt
- Midjourney Docs: Prompt Basics https://docs.midjourney.com/hc/en-us/articles/32023408776205-Prompt-Basics
- Midjourney Docs: Text Generation https://docs.midjourney.com/hc/en-us/articles/32502277092109-Text-Generation
- Google AI Studio: Changelog https://aistudio.google.com/docs/changelog
- ChatGPT on X, September 8, 2026 https://x.com/ChatGPT/status/2097411337064227032
- Google Gemini on X, April 13, 2026 https://x.com/GeminiApp/status/2043779910708408577
- Max Woolf: Nano Banana can be prompt engineered for extremely nuanced AI image generation https://minimaxir.com/2025/11/nano-banana-prompts/
- GitHub: minimaxir/nano-banana-tests https://github.com/minimaxir/nano-banana-tests
- pixegami on YouTube: Nano Banana Full Guide and Best Practices for AI Image Generation https://www.youtube.com/watch?v=XZALWN0wv48