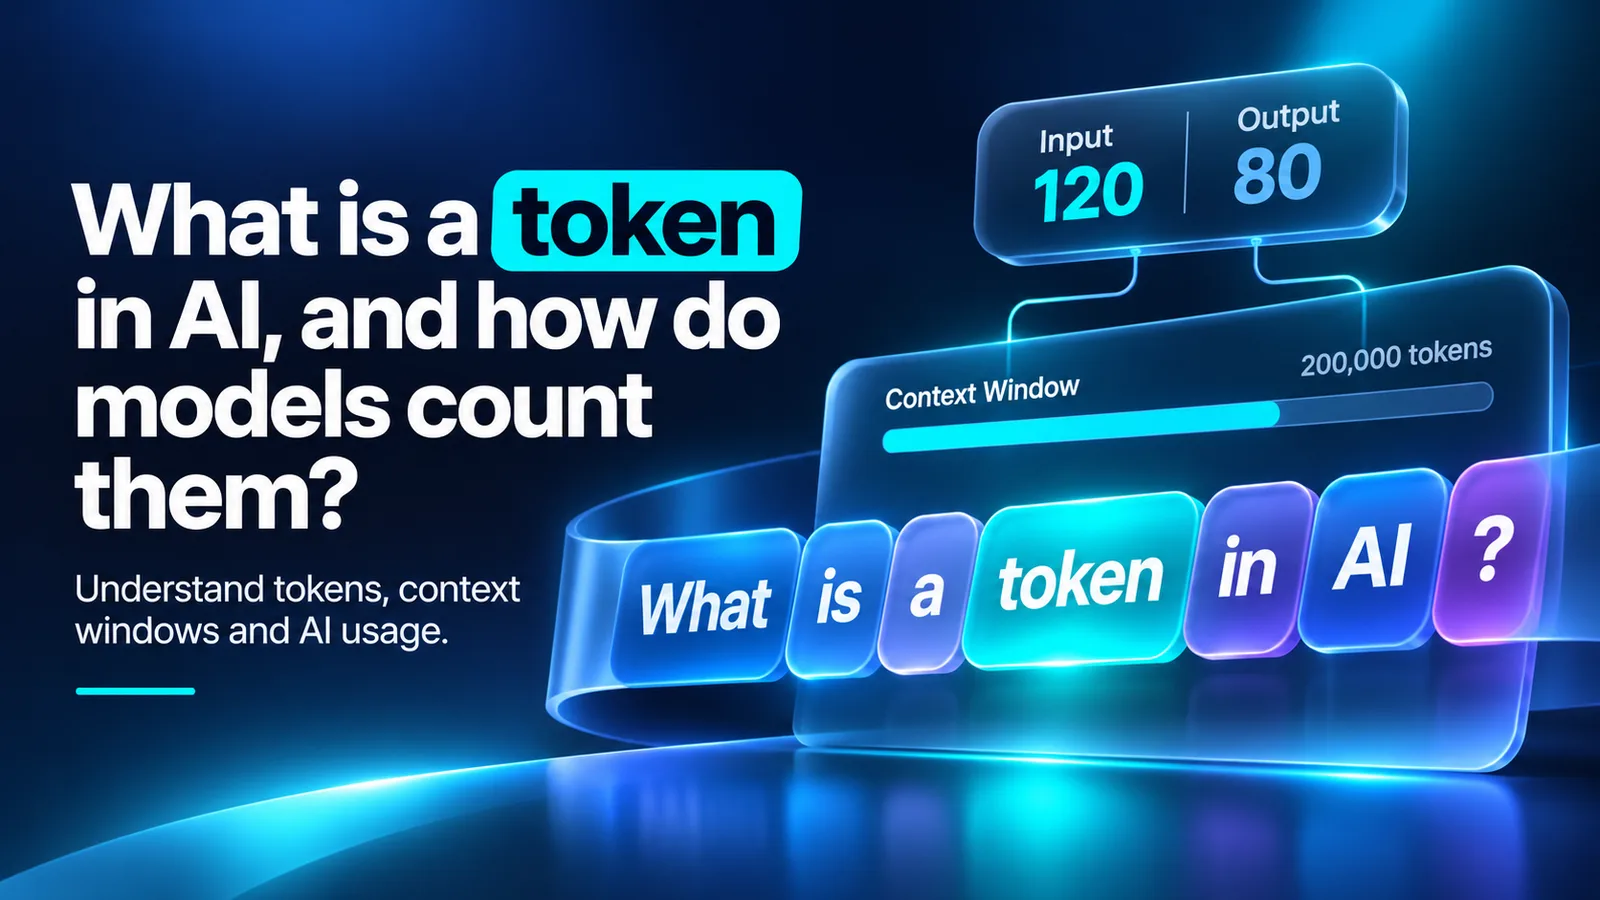
token 不是词,而是一段段文字
给 Claude 一句英文系统提示(意思是“你是一位科学家”),再发一条英文消息(意思是“你好,Claude”)。Anthropic 的 token 计数文档给出的结果是 14 个输入 token,而这个请求只有 6 个英文单词。
模型看到文字之前,分词器(tokenizer)先把它切成一个个 token,也就是语言模型处理的最小单位。常见的短词通常一个词就是一个 token。英文里一个词的第一个 token,一般带着它前面的空格。
英文那条估算比例,到中文或德文就不管用了,英文里各家也不一样。最新的 Claude 模型换了新的分词器,同样的文字,切出来的 token 比之前的 Claude 模型多约 30%。
| 模型 | 大约每个 token 对应 | 出处 |
|---|---|---|
| OpenAI 的模型 | 4 个字符,或 0.75 个英文单词 | OpenAI API 概念页 |
| Claude 4.7 之前的模型 | 3.5 个英文字符 | Anthropic 术语表 |
| Claude 4.7 及之后的模型 | 同样的文字比旧模型多出约 30% 的 token | Anthropic 术语表和 token 计数文档 |
发送之前怎样数 token
这个数出自 Anthropic 的 token 计数接口。它只告诉你这个请求会用掉多少输入 token,请求并不会真的发给模型。这个数是估算值,和实际请求可能有少许出入。Anthropic 为系统优化自动加入的 token 也可能算在里面,这部分不计费。Anthropic 写明,数 token 本身免费。它有单独的每分钟请求数上限,按你的使用等级设定,和创建消息的上限分开,不占发消息的额度。
curl https://api.anthropic.com/v1/messages/count_tokens \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "content-type: application/json" \
    -H "anthropic-version: 2023-06-01" \
    -d '{
      "model": "claude-opus-5-5",
      "system": "You are a scientist",
      "messages": [{
        "role": "user",
        "content": "Hello, Claude"
      }]
}'- 按真正要发送的样子组好请求:模型 ID、系统提示、消息,以及全部工具定义。
- 把它发到
/v1/messages/count_tokens,而不是/v1/messages。返回只有一个数,上面这个请求是{ "input_tokens": 14 }。 - 图片和 PDF 用 base64 发送,因为这个接口不收指向网址或已上传文件的内容块。
- 换模型之前再数一次:Anthropic 建议拿同一个请求在两个模型上各数一次,再比较两个
input_tokens。 - 在 Claude Code 里,运行
/context可以按类别实时查看会话占用。/usage则列出本次会话里每个模型用掉的输入、输出和缓存 token。
输入 token、输出 token 和上下文窗口
在 Claude API 里,输入包括系统提示、每一条消息(连同其中的工具结果、图片和文档),以及你的工具定义。扩展思考(extended thinking)按输出算,每次响应都会在 usage 字段里报告这两个数。
上下文窗口装着模型写回复时能参考的全部文字,输入和正在生成的回复都占用它。
对话越聊越长,是因为每一轮都要把历史重新发一遍。上一轮的回复变成下一轮的输入,Claude Code 每次请求都会发送完整的对话。一个开了一整天的会话,到最后哪怕只问一句话,前面的全部内容也照样计入用量。
上下文多并不自动等于好。token 数越多,准确率和召回率越会下降,这种现象叫上下文腐化(context rot)。所以管好上下文里放什么,和有多大空间一样要紧。原文为英文。
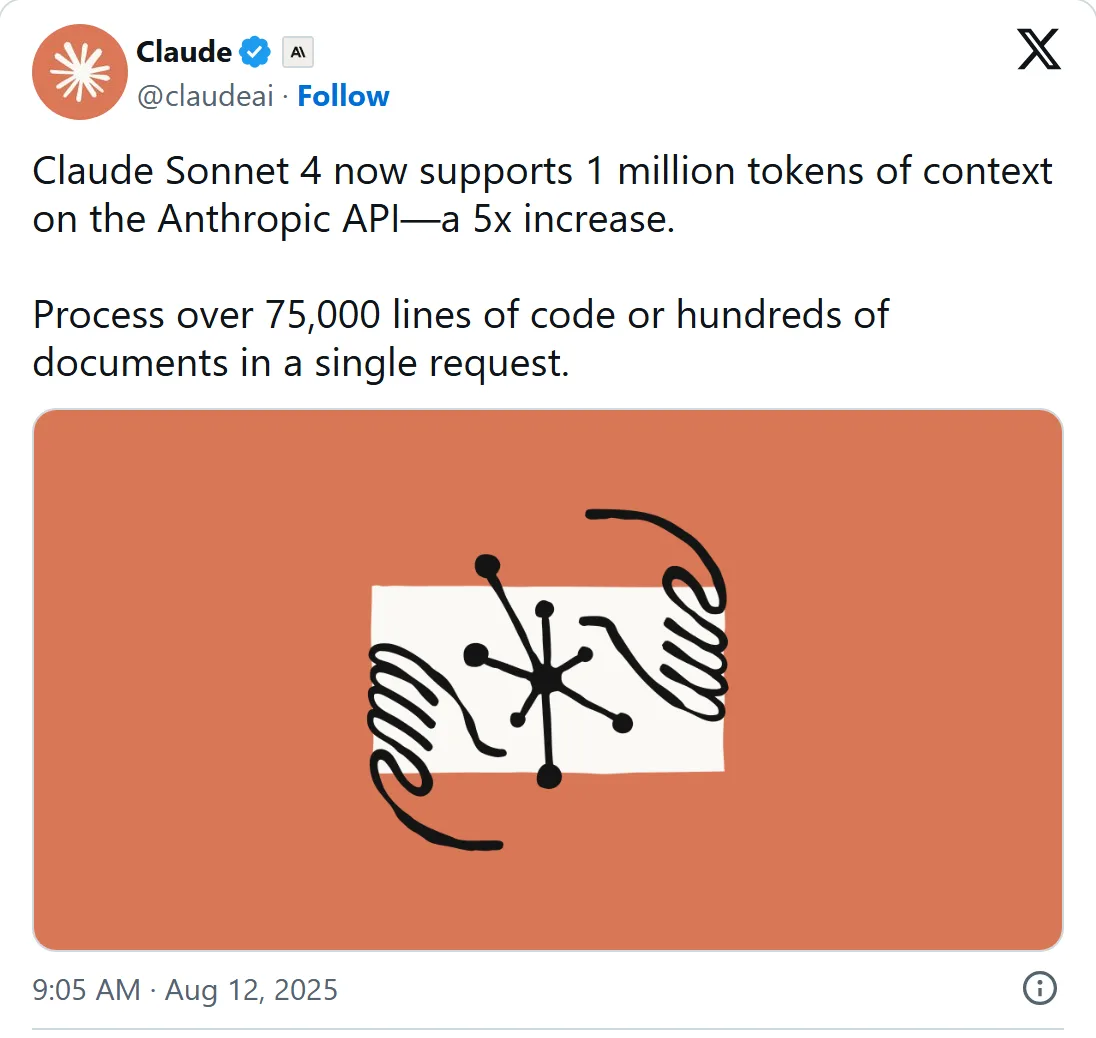
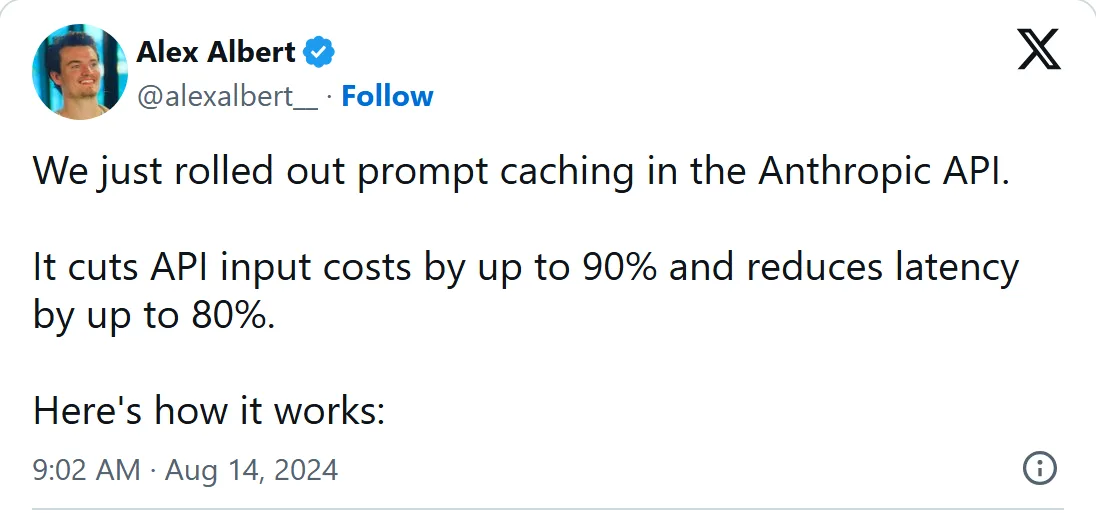
本页两张 X 截图都来自 X 官方嵌入组件,11 月 3 日截取,时间按美国太平洋时间显示。
提示缓存:重复的那部分不必每次重算
智能体每次请求的开头,大多一模一样:系统提示、工具定义、说明文件,还有对话的前半段。提示缓存让 API 从存好的前缀接着处理,不用每次从头再算,Anthropic 说这样能省下处理时间和费用。窗口并不会因此变大,缓存过的前缀照样占着位置,变的只是这些 token 的价格。
缓存的前缀按固定顺序拼成:先是工具,再是系统提示,然后是消息,而且必须完全一致。某一层一改,这一层和后面所有层的缓存都失效。工具排在最前,改一个工具定义,整个缓存就作废了。缓存条目默认保存 5 分钟,每次命中重新计时,另外还有 1 小时的选项。
那个“你是一位科学家”的请求太短,进不了缓存。短于模型门槛的请求,即使标了缓存,也会悄悄跳过缓存,不报任何错。Claude Haiku 4.5 的门槛在各模型里算高的。
在 Claude Code v2.1.251 或更高版本里,/usage 的 Session 区块会多出一行 Prompt cache,显示输入 token 中有多大比例来自缓存,以及未命中的次数。
装了技能和 MCP 服务器,也会占 token 吗?
会,哪怕整个会话一个都没用上。
每个已安装的 Agent Skill 从一开始就把名称和描述放进上下文,好让智能体知道有它。Agent Skills 规范估计每个技能约 100 个 token,正文要等任务对上了才加载。在 Claude Code 里,Claude 能自行调用的子智能体和命令,名称和描述每一轮也都留在上下文里。
Claude Code 给这份清单设了上限。每个技能的描述连同 when_to_use 的文字,最多保留 1,536 个字符,整份清单的预算是模型上下文窗口的 1%。超出预算时,Claude Code 先拿掉你最少调用的那些技能的描述,能触发它们的关键词也跟着没了。少用的技能就这样明明还装着,却再也触发不了。/doctor 可以估算这份清单的开销,/skill-doctor 能找出值得关掉的技能。
每接一个 MCP 服务器,就多出一批工具。工具定义进了上下文,就和消息一样算输入。Claude Code 默认延迟加载这些定义,在 Claude 真正用到某个工具之前,进入上下文的只有工具名称和服务器说明。在 API 上,工具搜索起同样的作用:不用一开始就发 50 个工具的定义,只发一个 tool_search 工具,其余的由 Claude 按需查找。Anthropic 建议在工具超过 20 个左右时启用。
CLAUDE.md 在每个 Claude Code 会话一开始就整个加载,Anthropic 建议它不超过 200 行。
| CLAUDE.md | Agent Skill 我们的选择 | MCP 服务器 | |
|---|---|---|---|
| 整个会话一个都没用上,也已在上下文里 | 是 | 是 | 是 |
| 放进去的是什么 | 整个文件,每个会话一开始就加载 | 每个技能的名称和描述,约 100 个 token | 工具名称和服务器说明(在 Claude Code 里) |
| 其余部分只在任务需要时加载 | 否 | 是 | Claude Code 默认如此,API 上要用工具搜索 |
| Anthropic 给的大小建议 | 控制在 200 行以内 | 描述最多保留 1,536 个字符 | 工具超过 20 个左右,就加上工具搜索 |
我们的选择:Agent Skill。 Anthropic 建议把针对特定流程的说明挪出 CLAUDE.md,放进用到时才加载的技能。
来源:Claude Code 文档:有效管理成本 (2026年11月3日 查阅);Claude Code 文档:技能 (2026年11月3日 查阅);Claude 平台文档:管理工具上下文 (2026年11月3日 查阅);Agent Skills 规范 (2026年11月3日 查阅)
从 token 数到每月估算
Anthropic 对输入、输出和缓存读取分别按每百万 token 定价,估月费要把这三项分别记下来。缓存第一次写入更贵,计算器页面也注明,实际省下的会略少一些。
| 字段 | 数字从哪里来 |
|---|---|
| 每天的 AI 会话数、每月天数 | 你自己的工作习惯 |
| 每次会话读取的 Token(千) | Claude Code 里的 /usage 或 /context,或 API 返回的 input_tokens |
| 每次会话写出的 Token(千) | /usage 里的输出数字,思考也算在内 |
| 读取内容里重复的比例(%) | /usage 里的 Prompt cache 一行 |
| 回答缩短后减少的输出(%) | 你自己定的目标,不是测量值 |
| 改用最便宜模型的会话(%) | 你估计能交给小模型的简单会话 |
参考:usage 里的缓存字段,以及各模型的缓存下限
每次响应的 usage 会把输入拆成三个数:
cache_read_input_tokens:这次请求从缓存里读出的 token。cache_creation_input_tokens:新建缓存条目时写进去的 token。input_tokens:剩下的部分,也就是最后一个缓存断点之后的 token。
来源:Claude 平台文档:提示缓存 (2026年11月3日 查阅)
下方来源列表里的页面,我们在 2026 年 11 月 2 日读过,其中四页第二天又读了一遍,没有上手实测。模型名称、上限和 Claude Code 的版本号变得很快。
常见问题
1,000 个 token 大约是多少个英文单词?
按 OpenAI 的经验估算,大约 750 个英文单词。
前几轮的思考 token,后面还会再算吗?
较新的模型会。前几轮的思考块留在对话里,后面每一轮都按输入计算。更早的模型会把它们去掉。思考按输出计费,也占用 max_tokens 的额度,并计入速率限制。
对话超出上下文窗口会怎样?
单是输入就超出窗口的请求,API 会直接拒绝,返回 400 错误,提示 prompt is too long。在 Claude 4.5 及更新的模型上,输入放得下、只是加上 max_tokens 才会超出的请求会被接受,生成到上限时以 model_context_window_exceeded 停下。Claude Code 则会在会话接近上限时,自动压缩较早的历史。
命令行工具比 MCP 服务器更省 token 吗?
通常是。Anthropic 的 Claude Code 成本指南认为,gh、aws、gcloud 这类命令行工具比 MCP 服务器更省上下文,它们不用逐个列出工具。Claude 可以直接在终端里运行它们,用不上的 MCP 服务器可以在 /mcp 里关掉。
资料来源
- Claude 平台文档:术语表 https://platform.claude.com/docs/en/about-claude/glossary
- Claude 平台文档:token 计数 https://platform.claude.com/docs/en/build-with-claude/token-counting
- Claude 平台文档:上下文窗口 https://platform.claude.com/docs/en/build-with-claude/context-windows
- Claude 平台文档:提示缓存 https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Claude 平台文档:管理工具上下文 https://platform.claude.com/docs/en/agents-and-tools/tool-use/manage-tool-context
- OpenAI API 文档:核心概念 https://developers.openai.com/api/docs/concepts
- Claude Code 文档:有效管理成本 https://code.claude.com/docs/en/costs
- Claude Code 文档:探索上下文窗口 https://code.claude.com/docs/en/context-window
- Claude Code 文档:技能 https://code.claude.com/docs/en/skills
- Claude Code 文档:插件概览 https://code.claude.com/docs/en/plugins
- Agent Skills 规范 https://agentskills.io/specification