
anaksor-ocr
Sokheng · 工具包
这个模型从文档、收据和路牌照片里读取高棉语和英语文字,用一个检测器找文本行,再用识别器读每一行。适合需要在 Python 里做高棉语 OCR 的开发者。
新上架
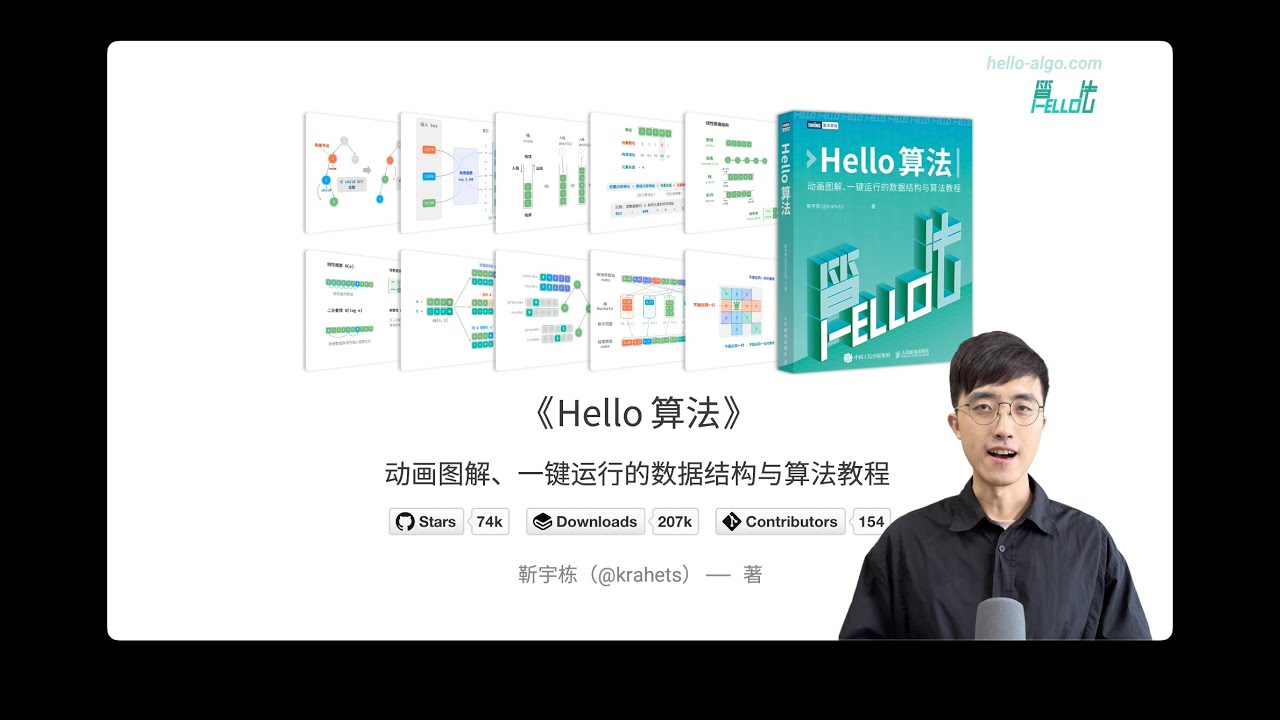


krahets 的开源免费数据结构与算法书,动画图解,代码可一键运行。有简体中文、繁体中文、英文、日文、俄文和韩文版。这里的说明涵盖网站、PDF 和 EPUB 文件、运行代码和 Docker。
Hello Algo《Hello 算法》 是一款 GitHub 上的开源项目,属于教育类,由 Mindket 上架。可免费获取。当前为第 2 版,最近更新于 。按它的 README 从 GitHub 安装。Mindket 的设置说明可在你的 Mindket 账户获取,以 zip 压缩包下载。
git clone https://github.com/krahets/hello-algo.git
Hello Algo(中文书名《Hello 算法》)是一本免费开源的数据结构与算法书,由 krahets 和许多贡献者在一个 GitHub 仓库里写成。中文 README 称它是“动画图解、一键运行的数据结构与算法教程”。这里的产品就是这本书。你可以在它的网站上读,也可以下载 PDF 或 EPUB,或者在自己的编辑器里读和运行,Mindket 的说明会讲每一种怎么做。仓库里有简体中文、繁体中文、英文、日文、俄文和韩文版本。
| 部分 | 章节 | 内容 |
|---|---|---|
| 基础 | 前言、初识算法 | 这本书写给谁、怎么读,以及算法是什么。前言还给出一条分三个阶段的学习路线。 |
| 复杂度分析 | 第 2 章 | 评价数据结构和算法的标准与方法,包括如何推导时间复杂度和空间复杂度、常见的复杂度类别和例子。 |
| 数据结构 | 第 3 到 9 章:数据结构、数组与链表、栈与队列、哈希表、树、堆、图 | 定义、优缺点、常见操作、变体、典型应用和实现。 |
| 算法 | 第 10 到 15 章:搜索、排序、分治、回溯、动态规划、贪心 | 定义、优缺点、效率、应用、解题步骤和例题。 |
| 附录 | 第 16 章 | 搭建编程环境、参与本书和术语表。 |
适合刚接触数据结构与算法、而且已经能用一门语言读写简单代码的初学者。书里“关于本书”一页也把它推荐给刷过一些题、但对背后的理论只有模糊认识的读者。已经熟悉常见题型的人可以拿它来复习,把仓库里的代码当作“算法字典”。
| 行业 | 谁在用 | 怎么用 | 例子 |
|---|---|---|---|
| 自学 | 刚学算法的程序员 | 在网页版上逐章阅读,先看动画,有问题就在页面底部的评论区里问 | 一位读者打开排序一章,先把快速排序的图一步步点过去,再读文字。 |
| 学生 | 修算法入门课的学生 | 配合课堂阅读,用课程所用的语言运行代码 | 一位上 Java 课的学生,在老师讲到同一个主题时,运行每一章对应的 Java 文件。 |
| 面试准备 | 求职者 | 先学完基础,也就是前言说的第一阶段,再去刷题 | 一位求职者把各章读完,再点开前言里作者的 LeetCode-Book 仓库去找题单。 |
| 教学 | 想要多语言免费教材的老师 | 让班级读自己语言的网页版,或者发 PDF、EPUB | 一位老师把同一章的英文版和简体中文版一起发给一个混合语言的班。 |
| 开源贡献 | 译者和代码移植者 | 改一页、补一种语言的代码,或审校译文 | 一位志愿者按英文贡献指南的要求,对照中文原文审校一章的英文。 |
如果你更想刷题而不是看讲解,可以先不看它。前言说这本书主要讲基础,并指向作者的 LeetCode-Book 仓库去找题单。
这本书可以在浏览器、电子书阅读器、你的编辑器和 Docker 里用。作者没有写任何编程智能体的用法,所以这些说明里也没有。
点“获取”会把一个装有 Mindket 说明的 zip 压缩包存进你的下载文件夹,里面为每一种阅读或运行这本书的方式各写了一份说明。在线阅读什么都不用装。
| 需要 | 说明 |
|---|---|
| 在线阅读 | 一个浏览器,什么都不用装 |
| PDF 或 EPUB | 一个 PDF 阅读器或电子书阅读器,再加上 releases 页面里的一个文件 |
| 运行代码 | Git,或者 GitHub 上的 Download ZIP 按钮,再加一个编辑器和一个语言环境。Python 需要 3.10 或更高版本 |
| 自己架一份网站 | Docker 和 Docker Compose |
en/codes 文件夹里打开一个源文件。代码块上方标着的文件名,就是告诉你该打开哪一个。git clone https://github.com/krahets/hello-algo.git
要架一份自己的网站,在仓库的根目录里运行下面这一行。之后英文版就在 http://localhost:8000/en/ 。
docker-compose up -d
下面这一行会再把这份网站撤掉。
docker-compose down
先读前言这一页,然后一章一章往下读,或者直接跳到你要的主题。前言页列出了本书的写作约定。
| 你看到的 | 意思 |
|---|---|
| 标题后有 * | 选读章节,内容更难。如果时间有限,可以先跳过 |
| 带下划线的词 | 网页版里的专业术语,纸质版和 PDF 里用黑体。建议记住它们 |
| 粗体文字 | 重点或总结性的话 |
| 引号 | 在特定含义下使用的词 |
| 用 None 表示空值 | 各编程语言对某个术语说法不一时,本书以 Python 为准 |
遇到带动画图解的段落,前言说先看图,再用文字来辅助理解。它还建议你有时间就自己把代码敲一遍,时间有限的话,至少把所有代码读一遍并运行。
网页版每个章节的底部都有评论区。前言说,作者和小伙伴们会尽力在那里回答,一般两天内回复,也希望读者互相解答。
你想弄懂快速排序。你在网站上打开 11.5 节。它用图一步步演示划分:先选出一个基准数,两个指针从两端往中间走,交换元素,直到相遇。然后你克隆仓库,在 VS Code 里打开这一节对应的 Python 文件:
en/codes/python/chapter_sorting/quick_sort.py
Mindket 把这一个文件复制到一个空文件夹里,在 2026 年 11 月 3 日用 Python 3.14 运行了它。它不需要别的文件。这个文件里有三个版本的快速排序,还有一段入口代码,用每个版本去排同样的六个数。输出是:
After quick sort, nums = [0, 1, 2, 3, 4, 5]
After quick sort (median pivot optimization), nums1 = [0, 1, 2, 3, 4, 5]
After quick sort (recursion depth optimization), nums2 = [0, 1, 2, 3, 4, 5]
这一页讲了第二个和第三个版本。取三个元素的中位数当基准数,慢速的情况就更少见,只对较短的一侧递归,则能让递归保持较浅。你可以改一改底部入口代码里的数字,再运行一次。
新手:序用日常的东西打了比方。冬天的衣服像一个栈,因为先穿上的后脱下。一筒羽毛球像一个队列,字典则像一个哈希表。第 2 章教你用耗费的时间和空间去比较算法。如果搭环境觉得麻烦,就先在线读整本书,那样什么都不用装。
专家:仓库把六个版本并排放着。简体中文版在根目录,zh-hant、en、ja、ru 和 ko 各有自己的 docs、自己的 codes 文件夹和自己的 mkdocs.yml。英文贡献指南把中文原文当作意思上的准绳。
在 GitHub 上看一页的 Markdown 源文件,看不到它的代码。快速排序那页的源文件里只有占位行,比如 [file]{quick_sort}-[class]{quick_sort}-[func]{partition},网站上才会在那里显示代码。要看代码,去 codes 文件夹。
英文版的 Python 文件夹里,每章一个文件夹,另有一个 modules 文件夹和 test_all.py。这个脚本会找出每个 chapter_*/*.py 文件,逐个运行,只要有一个失败就抛出错误。Go 文件夹在各章之外有一个 pkg 文件夹和一个 go.mod。章节练习页是生成的,英文指南说,措辞上的改动应该放到配套的 workspace 仓库里。
这些说明是 Mindket 自己写的,在 2026 年 11 月 3 日从仓库里读出来。它们不是 krahets 做的,也没有得到 krahets 的认可,里面没有书里的任何图片或代码。
这个工具包里只有安装说明,由 Mindket 编写。书、它的动画图解和它的代码都留在 krahets/hello-algo 仓库里,地址是 https://github.com/krahets/hello-algo
这些说明不是 krahets 写的,也没有得到 krahets 的认可。英文 README 称这本书是“A data structures and algorithms tutorial with animated illustrations and code you can run with one click”,意思是:一本动画图解、代码可一键运行的数据结构与算法教程。它还说“This project aims to create a free, open-source introduction to data structures and algorithms that is accessible to beginners.”,意思是:这个项目想做一本免费、开源、对初学者友好的数据结构与算法入门书。中文版的书名是《Hello 算法》。这些说明依据英文和简体中文的 README、英文版的文档页面和两个简体中文页面、仓库的 Docker 文件和 giscus.json、它在 GitHub 上的发布页、GitHub 的仓库 API 和它的文件夹列表写成,都在 2026 年 11 月 3 日读取。
许可证:仓库自己的许可证是 CC BY-NC-SA 4.0。README 的 License 一节写着“The texts, code, images, photos, and videos in this repository are licensed under CC BY-NC-SA 4.0.”,意思是:这个仓库里的文字、代码、图片、照片和视频都按 CC BY-NC-SA 4.0 授权。LICENSE 文件是 Creative Commons 的法律文本,第一行是“Attribution-NonCommercial-ShareAlike 4.0 International”。GitHub 对这个仓库的回答把许可证标为“Other”,SPDX 编号是 NOASSERTION。许可证名称里有 NonCommercial(非商业)和 ShareAlike(相同方式共享)。如果你打算把书里的文字、图片或代码用到你要出售的东西里,请先读 LICENSE 里的法律文本。这些说明只引用书里的几句短话,并写明每一句出自哪一页,里面没有书的图片或代码。
一本写给初学者的免费数据结构与算法书,由 krahets 和许多贡献者写成。英文 README 说“Animated illustrations throughout the book, clear explanations, and a gradual learning curve guide beginners through data structures and algorithms.”,意思是:全书用动画图解,讲解清楚,学习曲线平缓,带初学者走进数据结构与算法。它还说“Code that runs with one click helps readers build programming skills through practice and understand how algorithms work and how data structures are implemented.”,意思是:可以一键运行的代码帮助读者在练习中提高编程能力,并弄懂算法怎么工作、数据结构怎么实现。来源见 https://github.com/krahets/hello-algo/blob/main/en/README.md
书里的代码块顶部标有文件名时,“How to use this book”一页说,你可以在仓库的 en/codes 文件夹里找到那个文件。见 setup/run-the-code.md。
书的各章,按英文版目录的编号:
| 章 | 标题 |
|---|---|
| 0 | Preface(前言) |
| 1 | Getting to know algorithms(初识算法) |
| 2 | Complexity analysis(复杂度分析) |
| 3 | Data structures(数据结构) |
| 4 | Arrays and linked lists(数组与链表) |
| 5 | Stacks and queues(栈与队列) |
| 6 | Hash tables(哈希表) |
| 7 | Trees(树) |
| 8 | Heaps(堆) |
| 9 | Graphs(图) |
| 10 | Searching(搜索) |
| 11 | Sorting(排序) |
| 12 | Divide and conquer(分治) |
| 13 | Backtracking(回溯) |
| 14 | Dynamic programming(动态规划) |
| 15 | Greedy algorithms(贪心算法) |
| 16 | Appendix(附录:编程环境、参与本书、术语表) |
目录里在第 0 章前面还有一篇 Foreword(序),在第 16 章后面还有一页 References(参考文献)。来源见 https://github.com/krahets/hello-algo/blob/main/en/mkdocs.yml
仓库里有六种语言的书:简体中文在根目录,其余是繁体中文(zh-hant)、英文(en)、日文(ja)、俄文(ru)和韩文(ko)文件夹。README 的语言栏列出了这六个版本,并链接了其余五个。
读书的话什么都不用装。要运行书里的代码,你要装一个语言环境,附录会说是哪一个。见 setup/language-environments.md。要自己架一份网站,需要 Docker。见 setup/docker.md。
en/codes 里为英文版代码准备的 Docker 文件(每个版本的代码文件夹里都有这样一组)作者没有写任何编程智能体的用法:README 和读过的文档页面都没有提到。
克隆下来的仓库用普通的 Git 更新,ZIP 只是一份快照,所以以后有改动要重新下载(Mindket 的说明)。要删除克隆或 ZIP,删掉那个文件夹。在线阅读什么都不装。Docker 部署有它自己的移除命令,见 setup/docker.md。
extra_javascript)。git clone 和 releases 下载会连到 GitHub。README.md 7 KB setup/contribute-and-translate.md 4 KB setup/docker.md 4 KB setup/download-pdf-epub.md 3 KB setup/language-environments.md 4 KB setup/read-online.md 6 KB setup/run-the-code.md 5 KB
Updated by Mindket to the current version of this kit.
同一分类里与本产品共有主题最多的已上架 GitHub 项目。
| 产品 | 星标 | 许可证 |
|---|---|---|
| Hello Algo《Hello 算法》 本页 | 131,980 | — |
| Coding Interview University 面试计划共有 algorithms · data-structures · algorithm | 364,052 | CC-BY-SA-4.0 |
| The Algorithms Python 算法合集共有 algorithm · education | 225,927 | MIT |
Hacker News、Bluesky、X、Reddit、Facebook 和 YouTube 上提到这个项目的帖子和评论,来自每周一次的搜索和 Trendshift。它们不是 Mindket 写的,也未经核实,点开即可在原帖处阅读。
Sokheng · 工具包
这个模型从文档、收据和路牌照片里读取高棉语和英语文字,用一个检测器找文本行,再用识别器读每一行。适合需要在 Python 里做高棉语 OCR 的开发者。
Qwen · 工具包
Qwen2.5-7B-Instruct 的 GGUF 文件,提供八种量化大小,可通过 llama.cpp 在本地聊天。适合想在自己电脑上用 7.6B 强力模型、又不想搭 Python 环境的人。
ACE-Step · 工具包
用 4B 扩散解码器根据文字生成音乐,50 步并带引导控制,音频质量高于基础版。适合拥有 12 GB 或更多显存 GPU 的创作者。
jwasham · 工具包
jwasham 的数月学习计划,目标是成为软件工程师,写成一份很长的 README,里面有视频、讲座和要你自己实现的东西。安装说明涵盖 ZIP、用 Git 复刻、找到自己学到哪一节、选语言,以及让 Claude Code、Codex 或 Cursor 当你的辅导老师。
TheAlgorithms · 工具包
TheAlgorithms 的开源算法与数据结构合集,每一项都用 Python 写成,供学习使用。安装说明涵盖在 GitHub 或文档站点上阅读、克隆或 ZIP、运行文件的 doctest、开发容器,以及让 Claude Code、Codex 或 Cursor 当辅导老师。
prathoshap · 工具包
用一个训练好的声音,以吟诵风格朗读古典梵语诗节,由参考音频决定节奏。适合学习、背诵或需要梵语音频的人。