# 少样本提示:示例放几个、怎么排版、怎么排序
> 少样本提示就是在提示词里放几组输入和期望输出的示例,让模型照着示例的规律作答,不需要微调。OpenAI 把它叫作 few-shot learning,Anthropic 叫它 multishot prompting。光靠指令说不清格式、语气或标签时,就该用它。对推理模型,先试零个示例,不够再加三到五个彼此不同、各自包在标签里的示例。
Mindket 编辑部 · 发布于 2026-11-06 · 更新于 2026-11-06 · https://mindket.com/cn/learn/prompt-engineering-advanced/few-shot-prompting
## 要点
- 先写指令,只在回复反复偏离的地方补示例。
- 挑彼此不同、又像你的应用真正会收到的输入的示例。
- 每个示例单独包一个标签,并让规则和示例说同一件事。
- 一次跑分好看还不够,打乱顺序、分散标签之后再下结论。
- 工具的嵌套参数老是填错,就在工具定义里放调用样例。
## 开始之前
一个 shot 就是提示词里的一个示例:一段输入,加上你希望它得到的输出。零样本指提示词里只有指令;单样本多放一个示例;少样本则放上几个。
第一个练习用聊天应用就能做,后面的开发者消息需要一个 API 密钥。本课默认你已经会写清楚的指令,这是[提示词工程入门课](https://mindket.com/cn/learn/prompt-engineering/prompt-engineering-basics)讲的内容。示例是加在指令之上的,永远不能代替指令。
## 用一个示例改变回复的语气
Anthropic 的[交互式提示词教程](https://github.com/anthropics/prompt-eng-interactive-tutorial/blob/master/Anthropic%201P/07_Using_Examples_Few-Shot_Prompting.ipynb)第 7 章做了一个回答小朋友提问的“家长机器人”。直接问圣诞老人会不会送礼物,Claude 的回答很正式,教程说它像机器人。你可以花一整段话去描述想要的温柔语气,教程的做法是加一组问答当示例,整个提示词只有四行。
````text
Please complete the conversation by writing the next line, speaking as "A".
Q: Is the tooth fairy real?
A: Of course, sweetie. Wrap up your tooth and put it under your pillow tonight. There might be something waiting for you in the morning.
Q: Will Santa bring me presents on Christmas?
````
1. 打开一个新对话,只发最后一行:Will Santa bring me presents on Christmas?
2. 再打开一个新对话,把上面从教程里复制来的完整提示词发出去。
3. 把两次回复放在一起看,比较语气、长度,以及第二次是不是以“A”的身份在说话。
4. 再加一组别的话题的问答,比如玩具丢了,在新对话里重新发送。
5. 留下你愿意直接上线的那一版,并记下是哪个示例改变了什么。
## 给示例单独的段落和标签
在应用里,示例通常放在开发者消息中,也就是你的代码在用户输入之前发出的那段指令。OpenAI 的[提示词工程指南](https://developers.openai.com/api/docs/guides/prompt-engineering)把这段消息分成几个带标题的部分,并给出一个商品评论分类器。每条示例评论都包在一个标签里,用 id 和模型应该返回的标签对应起来。
指南说,模型会从示例里领会规律,再用到下一个输入上,它还要求示例覆盖尽量多样的输入。
````text
# Identity
You are a helpful assistant that labels short product reviews as
Positive, Negative, or Neutral.
# Instructions
* Only output a single word in your response with no additional formatting
or commentary.
* Your response should only be one of the words "Positive", "Negative", or
"Neutral" depending on the sentiment of the product review you are given.
# Examples
I absolutely love this headphones — sound quality is amazing!
Positive
Battery life is okay, but the ear pads feel cheap.
Neutral
Terrible customer service, I'll never buy from them again.
Negative
````
- 标签标出每条示例从哪里开始、到哪里结束,模型就分得清哪条是示例,哪条是它要打标签的评论。
- 三条示例正好用到三个标签,模型能看到它被允许给出的每一种答案。
- 规则写的就是示例展示的东西:只输出一个词,别的什么都不要。OpenAI 的 [GPT-4.1 提示词指南](https://developers.openai.com/cookbook/examples/gpt4-1_prompting_guide)正是这样要求的:示例里演示的任何行为,规则里也要写出来。
- Anthropic 的[应用提示词课程](https://github.com/anthropics/courses/blob/master/real_world_prompting/01_prompting_recap.ipynb)把每个示例包在 `example` 标签里,再统一放进一个 `examples` 标签。两种写法都行,选定一种,整个提示词保持一致。
## 示例该放几个
Anthropic 的课程说,这件事没有硬性规定。它建议一开始至少放三到五个,回复还有偏差的地方再补有针对性的示例,并提醒哪怕只有一个示例,也比没有强。每个示例在每次调用时都要占输入 token。同一块示例反复发送时,[提示词缓存](https://mindket.com/cn/learn/claude-api/claude-prompt-caching)能让 API 直接从缓存里读取。
推理模型改变了起点。OpenAI 的[推理模型最佳实践](https://developers.openai.com/api/docs/guides/reasoning-best-practices)说,这类模型往往不需要示例,所以先写不带示例的提示词。只有输出要求比较复杂时才加几个,而且要和指令严格一致,两者对不上可能得到很差的结果。
这个说法来自 GPT-3。2020 年的论文 [Language Models are Few-Shot Learners](https://huggingface.co/papers/2005.14165) 只用文字把示例交给这个 1750 亿参数的模型,没有任何梯度更新或微调。在一些任务上,这样就足以和当时最好的微调系统一较高下。
| 你的情况 | 从哪里开始 | 原因 |
| --- | --- | --- |
| 推理模型做开放式任务 | 不放示例 | OpenAI 说这类模型不放示例往往也做得好 |
| 标签固定,或输出格式严格 | 三到五个示例 | 示例展示格式,比文字描述快 |
| 很难说清的语气 | 一两个示例 | Anthropic 认为给一两个示例,往往比描述每个细节更高效 |
| 带嵌套可选参数的工具 | 在工具定义里放调用样例 | schema 表达不了哪些字段该一起出现 |
## 模型从示例里学到了什么
示例里的答案对不对,没有大多数人想的那么重要。2022 年的研究 [Rethinking the Role of Demonstrations](https://huggingface.co/papers/2202.12837) 把示例里的标签随机替换,在包括 GPT-3 在内的 12 个模型上,分类和多选题的成绩几乎没有下降。真正起作用的是其余部分:可选标签的范围、输入文本的类型,以及整体格式。
顺序同样会影响结果。一项以 GPT-3 等当时模型为对象的[提示词顺序研究](https://huggingface.co/papers/2104.08786)发现,同样的示例换个顺序,成绩可能从接近当时最佳变成和瞎猜差不多。对一个模型好用的顺序,换到另一个模型上并不成立。一篇 [2021 年的校准论文](https://huggingface.co/papers/2102.09690)把部分波动归因于偏向:GPT-3 这类模型更容易给出放在提示词末尾附近的答案。
这三项研究做于 2021 和 2022 年,测的是当时的模型,不是你今天调用的模型。不过它们指向的做法几乎没有成本:示例要多样,标签要分散,示例块别总以最常见的那个标签收尾。在信任一个提示词之前,把示例打乱顺序多跑几次。
## 在工具定义里放调用样例
工具调用也有同样的问题。JSON Schema 只说明哪些字段合法,却说不出它们该怎样搭配,比如接口要哪种日期格式,严重故障要带上哪些可选字段。Anthropic 的[高级工具使用文章](https://www.anthropic.com/research/advanced-tool-use)把调用样例直接写进工具定义的 `input_examples` 字段。文章说,Claude 从三个样例里学会了日期和 ID 的格式、怎样嵌套联系人对象,以及哪些可选字段该一起出现。
[Claude 工具使用这一课](https://mindket.com/cn/learn/claude-api/claude-tool-use)讲了这个字段,以及每个样例要花多少 token。文章也列出了样例帮助不大的情况:只有一个明显参数的工具,以及 URL、电子邮件地址这类标准格式。
**复杂参数处理的准确率** Anthropic 的内部测试,2025 年 11 月 24 日发布,文章没有写明模型。金色柱加了工具使用示例。
- 不加工具使用示例: 72%
- 加上工具使用示例: **90%**
来源:[Anthropic: Introducing advanced tool use](https://www.anthropic.com/research/advanced-tool-use) (2026-11-06 查阅)
## anton 和 Alex Albert 谈少样本示例与提示词缓存
anton 的 X 账号是 @abacaj。他 2024 年 8 月 6 日[在 X 上写道](https://x.com/abacaj/status/1820907327001678254),就提升前沿模型的表现而言,少样本提示是“S 级”。帖子停在“把示例数量增加到 10 个以上,回报是”这半句,X 在这里用“Show more”把它截断了,所以他接着说了什么,这里读不到。
九天后,Anthropic 的 Alex Albert [在 X 上发了一串帖子](https://x.com/alexalbert__/status/1824136128850723084)谈提示词缓存,这项功能前一天刚在 Anthropic API 上线。他写道,缓存能大幅降低 API 的输入成本和延迟。他最兴奋的一点是,缓存让“超大规模的少样本提示”成了微调的轻量替代。
两条帖子都已经超过两年,而两家厂商现在的指南仍然推荐用示例。写你自己的提示词时,先按 Anthropic 课程的建议放三到五个。只有测试集表明多加的示例确实有用时才继续加,示例块变长以后就把它缓存起来。
> 这个任务该这样解,这里有几个示例,演示怎样解它。
>
> anton (@abacaj), 引文为译文, [X](https://x.com/abacaj/status/1820907327001678254) (2026-11-06 查阅)
[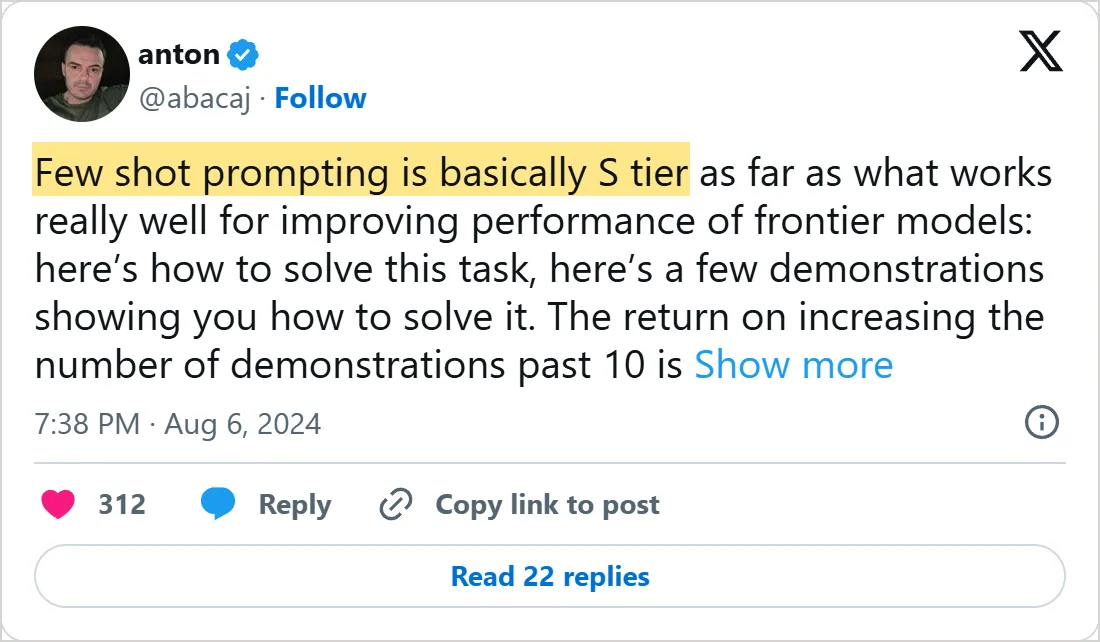](https://x.com/abacaj/status/1820907327001678254)
anton 在 X 上,2024 年 8 月 6 日
[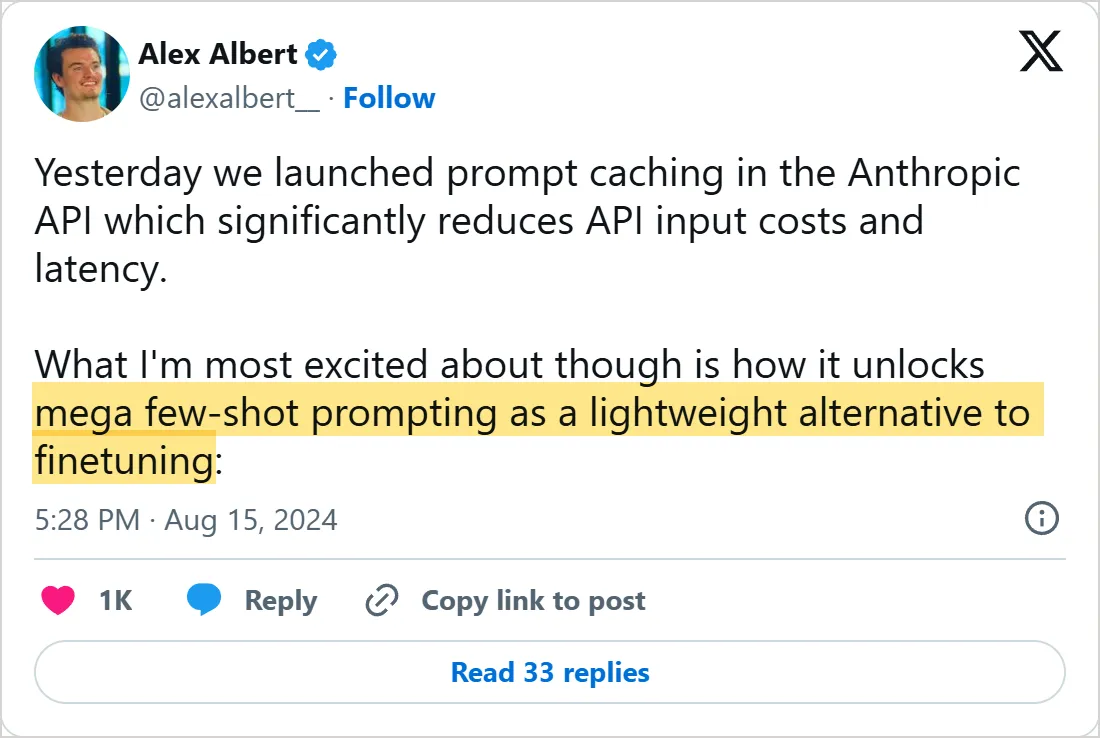](https://x.com/alexalbert__/status/1824136128850723084)
Alex Albert 在 X 上,2024 年 8 月 15 日
[AI prompt engineering: A deep dive](https://www.youtube.com/watch?v=T9aRN5JkmL8)
Anthropic 的四位提示词工程专家 Amanda Askell、Alex Albert、David Hershey 和 Zack Witten,聊怎样改进提示词,以及提示词工程的变化,发布在 Anthropic 自己的频道上。
> X 官方嵌入卡片的截图,拍摄于 2026 年 11 月 6 日,时间为 UTC。X 在第一条帖子处用“Show more”截断了后面的内容。点击截图可到 X 上打开原帖。
## 常见错误
- 贴上五个几乎一样的示例,模型学到的是它们共同的怪癖,而不是任务本身。
- 示例违反了规则,比如规则要求一句话,示例却写了两句。
- 示例和真实输入混在一起、没有标签,结果模型回答的是示例。
- 每个示例块都以同一个标签收尾,再把结果的偏向当成模型自己的判断。
- 还没试过不带示例的提示词,就给推理模型加示例。
- 只按一种示例顺序跑一次,就给提示词下结论。
## 自己试一试
每个练习只改评论分类器里的一处,这样你能看清这一处到底起了什么作用。分类器表现稳定以后,[下一课](https://mindket.com/cn/learn/prompt-engineering-advanced/chain-of-thought-prompting)会让模型在给出答案之前先写出推理过程。
- 加第四条评论,有夸有骂,发给分类器。返回的是哪个标签?
- 调换三条示例的顺序,再发同一条评论。标签变了吗?
- 删掉 Examples 部分,只保留规则,用你自己的五条评论比较返回的标签。
- 给你用的某个工具写一个 `input_examples` 条目:一个填满所有字段的调用,一个只填必填字段的调用。
## 自测一下
1. 2022 年的一项研究把少样本示例里的标签随机替换,结果怎样?
A. 成绩跌到和瞎猜一样
B. 在 12 个模型上几乎没有变化
C. 每个任务的成绩都提高了
D. 模型拒绝回答
答案:B。 研究发现,起作用的是标签范围、输入类型和格式,而不是每个标签对不对。
2. 你要让推理模型做一个新任务,第一步该试什么?
A. 放十个各不相同的示例
B. 放标签随机的示例
C. 写一个不带示例的提示词
D. 启动一次微调
答案:C。 OpenAI 的推理模型最佳实践说,这类模型往往不需要示例,提示词本身不够时再加几个。
3. OpenAI 的评论分类器为什么把每条示例放进单独的标签?
A. 让模型分清哪条是示例、哪条是要打标签的评论
B. 因为 API 不接受纯文本
C. 为了让提示词更短
D. 为了让模型用 XML 回复
答案:A。 标签标出每条示例的起止位置,id 再把每条示例评论和它的标签对应起来。
4. 一个带嵌套可选字段的工具,调用老是格式出错。Anthropic 建议怎么做?
A. 删掉可选字段
B. 在用户消息里描述这个工具
C. 调高 temperature
D. 在 input_examples 里加调用样例
答案:D。 schema 只说明哪些字段合法,调用样例才能展示格式和哪些字段该一起出现。
## 常见问题
### 什么是少样本提示?
就是在提示词里用示范来教模型做一个任务。研究者把这种效果叫作上下文学习,因为模型在权重完全不变的情况下适应了任务。
### 零样本提示和少样本提示有什么区别?
零样本只给指令,少样本还加上示例。零样本更省钱,在推理模型上往往就够了。少样本能把文字很难说清的格式、标签范围或语气固定下来。
### 少样本提示算一种微调吗?
不算。微调是用训练数据改变模型的权重。示例只存在于提示词里,所以每次调用都要花输入 token,一旦删掉就不再起作用。OpenAI 的指南把示例说成是不做微调也能引导模型的办法。
### 在 API 请求里,示例应该放在哪里?
OpenAI 的指南把示例放在开发者消息里,排在身份和指令之后。Anthropic 的课程把示例放在用户消息里,包在 `examples` 标签中。无论哪种,都把固定不变的示例块放在靠前的位置,方便缓存复用。[系统提示词这一课](https://mindket.com/cn/learn/prompt-engineering/system-prompt)讲了前面还该放些什么。
### 能给模型看“不要这样做”的示例吗?
能。Anthropic 的教程把“你不希望模型怎样做”的示例也算作有用的示例。每个反面示例单独放进一个标签,并写明它错在哪里,免得模型照抄。
## 资料来源
- [OpenAI Docs: Prompt engineering, Few-shot learning](https://developers.openai.com/api/docs/guides/prompt-engineering) (2026-11-06 查阅)
- [OpenAI Docs: Reasoning best practices](https://developers.openai.com/api/docs/guides/reasoning-best-practices) (2026-11-06 查阅)
- [OpenAI Cookbook: GPT-4.1 Prompting Guide](https://developers.openai.com/cookbook/examples/gpt4-1_prompting_guide) (2026-11-06 查阅)
- [Anthropic on GitHub: Prompt engineering interactive tutorial, chapter 7, Using Examples](https://github.com/anthropics/prompt-eng-interactive-tutorial/blob/master/Anthropic%201P/07_Using_Examples_Few-Shot_Prompting.ipynb) (2026-11-06 查阅)
- [Anthropic on GitHub: Applied prompting course, lesson 1, Essential prompting techniques](https://github.com/anthropics/courses/blob/master/real_world_prompting/01_prompting_recap.ipynb) (2026-11-06 查阅)
- [Anthropic: Introducing advanced tool use](https://www.anthropic.com/research/advanced-tool-use) (2026-11-06 查阅)
- [Hugging Face Papers: Language Models are Few-Shot Learners (2020)](https://huggingface.co/papers/2005.14165) (2026-11-06 查阅)
- [Hugging Face Papers: Rethinking the Role of Demonstrations (2022)](https://huggingface.co/papers/2202.12837) (2026-11-06 查阅)
- [Hugging Face Papers: Fantastically Ordered Prompts and Where to Find Them (2022)](https://huggingface.co/papers/2104.08786) (2026-11-06 查阅)
- [Hugging Face Papers: Calibrate Before Use (2021)](https://huggingface.co/papers/2102.09690) (2026-11-06 查阅)
- [X: anton (@abacaj) on few-shot prompting working well on frontier models](https://x.com/abacaj/status/1820907327001678254) (2026-11-06 查阅)
- [X: Alex Albert on prompt caching and mega few-shot prompting](https://x.com/alexalbert__/status/1824136128850723084) (2026-11-06 查阅)
- [YouTube: Anthropic, AI prompt engineering: A deep dive](https://www.youtube.com/watch?v=T9aRN5JkmL8) (2026-11-06 查阅)
[浏览技能](https://mindket.com/cn/skills)